MIT 6.S184课程笔记6-Discrete Diffusion Models
这个系列是MIT 6.S184 - Introduction to Flow Matching and Diffusion Models的同步课程笔记。本门课程面向希望深入理解流模型与扩散模型的学生和研究者,从最基础的数学工具出发,逐步推导这些模型背后的数学原理,并介绍相应的训练与采样算法。本节课主要介绍离散扩散模型的相关技术。
前面的课程中我们已经介绍了flow matching和扩散模型的基本原理以及实现方法。本节课我们将介绍更前沿的离散扩散模型(discrete diffusion model)技术,这也是目前各大科技公司竞相投入的研究热点。
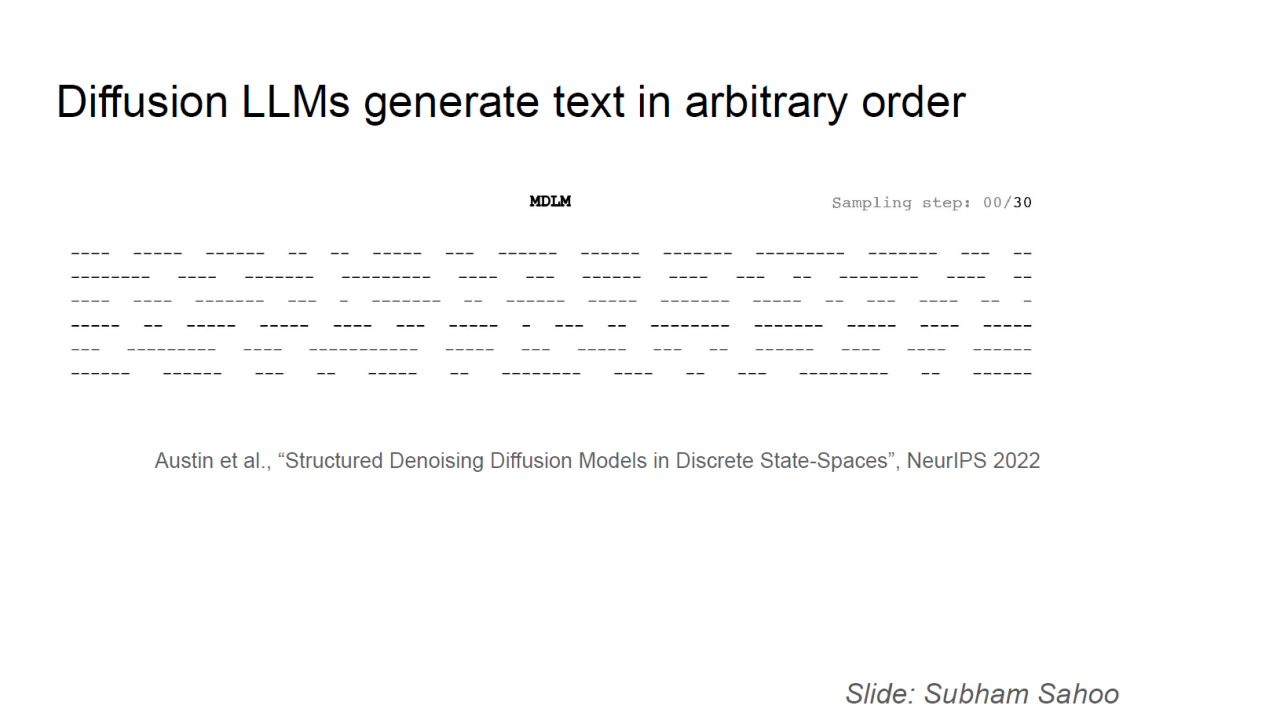
离散扩散模型可以对离散形式的数据进行建模。以语言模型为例,基于离散扩散的语言模型允许以任意顺序生成文本,而目前主流的大语言模型只能严格按照从左到右的顺序逐词生成。
从某种意义上讲,离散扩散模型可以理解为flow matching和扩散模型在离散数据上的推广。
Continuous-time Markov Chain
离散扩散模型的数学基础是连续时间Markov链(continuous-time Markov chain, CTMC),因此需要先补充一些背景知识。由于目前离散扩散模型大多应用在语言模型上,下面的介绍也以语言模型为主要场景。在离散扩散模型中,基本的数据单元是词汇表(vocabulary)
\[\mathcal{V} = \{ v_1, v_2, \dots, v_V \}\]其中\(V \in \mathbb{N}\)是词汇表的大小。
状态空间(state space)是由词汇表构成的序列
\[S = \mathcal{V}^d\]其中\(d \in \mathbb{N}\)是序列的长度。以语言模型为例,词汇表可以是自然语言中的词或字母,而状态空间则是由这些词组成的长度为\(d\)的序列;对于DNA建模,词汇表是4种碱基,状态空间则是由碱基组成的DNA序列。
此外,CTMC还要求状态之间的转移满足Markov性,即未来的状态只依赖于当前状态,而与更早的历史无关:
\[p(X_{t+h} \,\vert\, X_t, X_{t_1}, \cdots, X_{t_k}) = p(X_{t+h} \,\vert\, X_t) \quad \text{for all } 0 < h,\ 0 \leq t_1 < t_2 < \cdots < t_k < t\]Rate Matrix
CTMC中的一个核心概念是速率矩阵(rate matrix),它是一个三元映射
\[Q : S \times S \times [0, 1] \to \mathbb{R}, \quad (x, y, t) \mapsto Q_t (y \vert x)\]rate matrix描述了\(t\)时刻从状态\(x\)转移到状态\(y\)的速率,它满足如下两条性质:
- 非对角元非负:\(Q_t (y \vert x) \geq 0,\ \forall y \neq x\)
- 对角元等于非对角元之和的相反数:\(Q_t (x \vert x) = -\sum_{y \neq x} Q_t (y \vert x) \leq 0\)
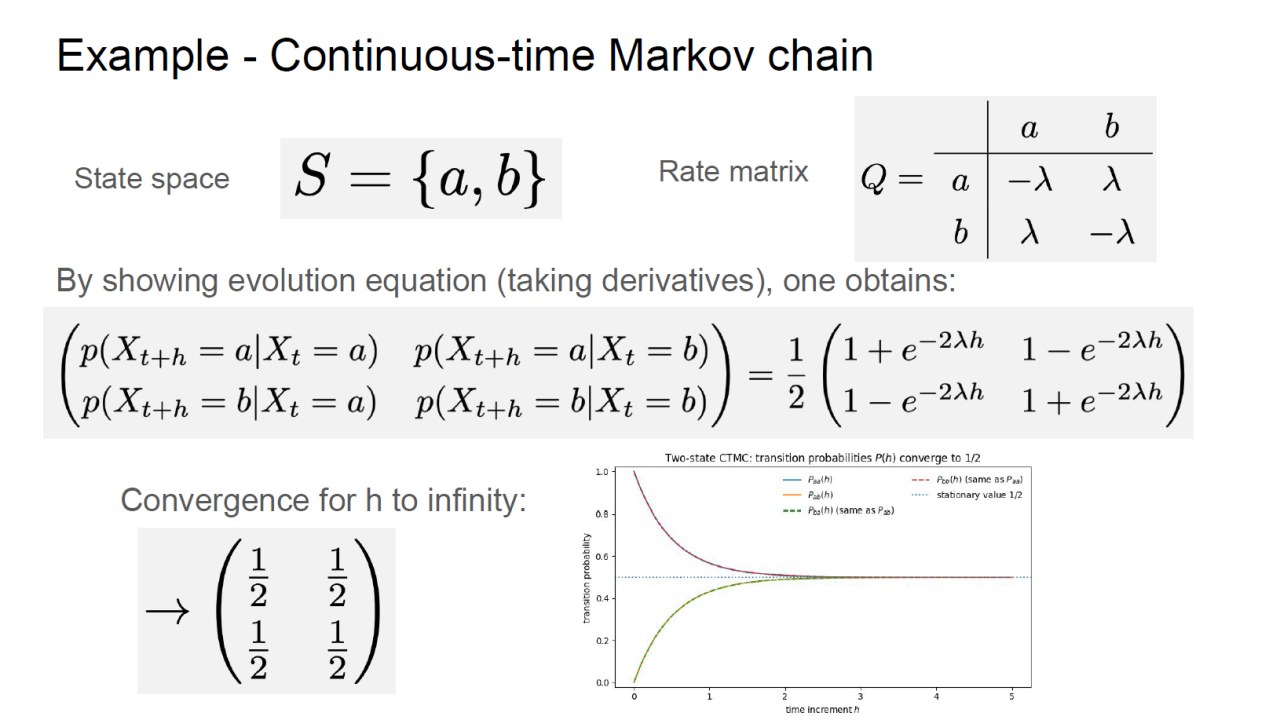
因此rate matrix的每一行元素之和恒为零。需要注意的是,rate matrix并不是状态之间的转移概率,它刻画的是转移概率随时间的变化率:
\[\frac{\mathrm{d}}{\mathrm{d}h} p_{t+h \vert t} (X_{t+h} = y \vert X_t = x) \Big|_{h=0} = Q_t (y \vert x) \quad \text{for all } x, y \in S,\ 0 \leq t\]下图给出了一个简单的例子展示如何从rate matrix来计算出状态转移矩阵,其中两个状态之间的转移概率会随着时间的推移趋向于0.5。
Factorization Condition
使用神经网络来实现CTMC模型时,只需要对rate matrix进行参数化即可。具体来说,我们用一个神经网络来表达\(Q_t^\theta\):对于给定的输入状态\(x\),网络输出对应的rate matrix
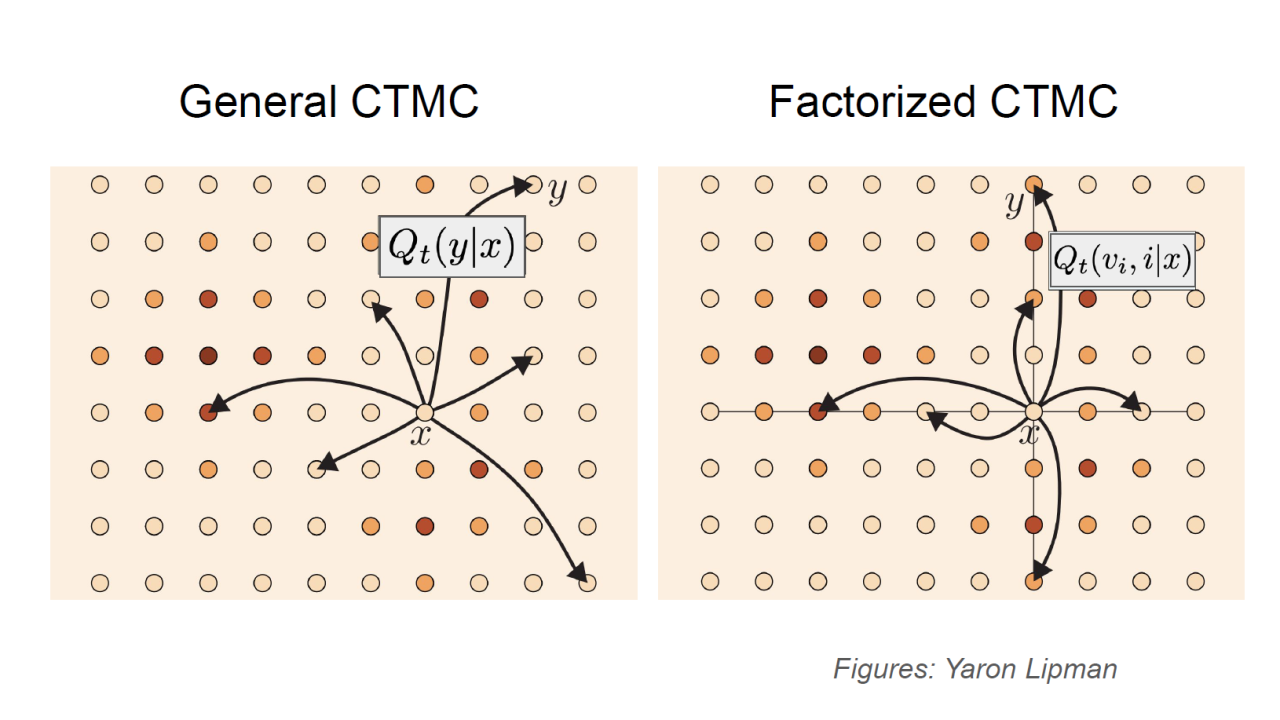
\[x \mapsto \{ Q_t^\theta ( y \vert x ) \}_{y \in S}\]然而这种建模方式存在一个问题:状态空间的大小为\(\vert S \vert = V^d\),它随着序列长度\(d\)呈指数增长。这就意味着直接对整个状态空间建模需要巨大的存储与计算开销,往往是不现实的。因此在实践中我们会对CTMC进行因子分解(factorization),即假设每次转移时至多只改变序列中的一个token。用数学语言可以表示为:
\[Q_t^\theta ( y \vert x ) = 0 \quad \text{whenever } y_i \neq x_i \text{ for more than one position}\]满足这一条件的状态\(y\)(即与\(x\)至多只在一个位置上不同的状态)称为\(x\)的邻居(neighbor),记为\(N(x)\)。于是分解后的CTMC模型可以表示为:
\[x \mapsto \{ Q_t^\theta (y \vert x) \}_{y \in N(x)} = \begin{pmatrix} Q_t^\theta (v_1, 1 \vert x) & \cdots & Q_t^\theta (v_V, 1 \vert x) \\ \cdots \\ Q_t^\theta (v_1, d \vert x) & \cdots & Q_t^\theta (v_V, d \vert x) \end{pmatrix}\]其中\(Q_t^\theta (v_i, j \vert x)\)表示把输入状态\(x\)的第\(j\)个token替换为词汇表中的第\(i\)个token\(v_i\)的速率,即\(y = (x_1, \cdots, x_{j-1}, v_i, x_{j+1}, \cdots, x_d)\)。这样一来网络的输出就退化为一个\(d \times V\)的矩阵,所需的存储开销随序列长度\(d\)从指数增长降为线性增长,问题的规模也就得到了控制。
Sampling CTMC Models
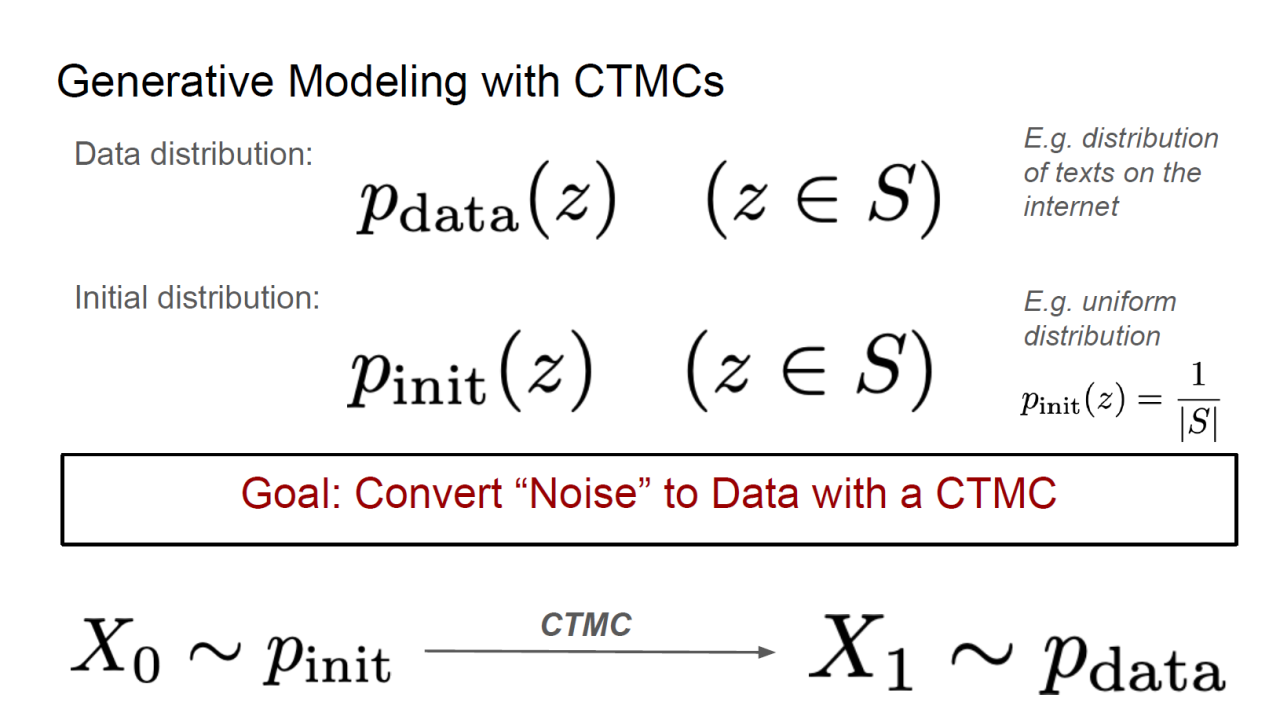
接下来考虑如何从CTMC模型中采样,这一过程与一般的Markov链采样并没有太大区别。假设\(t=0\)时刻的样本来自于初始分布\(p_\text{init}\),那么任意时刻的状态满足\(X_{t + h} \sim p_{t + h \vert t} (\cdot \vert X_t)\)。利用Taylor展开以及rate matrix的定义可以得到:
\[\begin{aligned} p_{t + h \vert t} (X_{t + h} = y \vert X_t = x) &\approx p_{t \vert t} (X_t = y \vert X_t = x) + h Q_t (y \vert x) \\ &= \delta_y (x) + h Q_t (y \vert x) \\ &\coloneqq \tilde{p}_{t + h \vert t} (y \vert x) \end{aligned}\]上式说明,只要沿时间轴不断从\(\tilde{p}_{t + h \vert t} (y \vert x)\)中采样,就能得到样本的演化轨迹。整理一下即可得到CTMC模型的采样算法:
\begin{algorithm}
\caption{Sampling from a Factorized CTMC Model}
\begin{algorithmic}
\REQUIRE Rate network $Q_t^\theta$ (factorized), initial distribution $p_\text{init}$, number of steps $n$
\STATE Set $t \leftarrow 0$, step size $h \leftarrow \frac{1}{n}$
\STATE Draw a sample $X_0 \sim p_\text{init}$, where $X_0 = (X_0^{(1)}, \dots, X_0^{(d)}) \in \mathcal{V}^d$
\FOR{$i = 1, \dots, n$}
    \STATE Compute factorized jump rates $\{ q_j (v) \}_{j = 1, \dots, d,\ v \in \mathcal{V}} \leftarrow Q_t^\theta (\cdot \vert X_t)$
    \FOR{$j = 1, \dots, d$ (in parallel)}
        \STATE $x \leftarrow X_t^{(j)}$ (current token at position $j$)
        \STATE Define the per-position Euler transition probabilities $\tilde{p}_{j,t} (v \vert x)$ by $\tilde{p}_{j,t} (v \vert x) = h q_j (v)$ for $v \neq x$, and $\tilde{p}_{j,t} (x \vert x) = 1 - h \sum_{v' \in \mathcal{V} \setminus \{x\}} q_j (v')$
        \STATE Sample $X_{t+h}^{(j)} \sim \text{CATEGORICAL}(\{ \tilde{p}_{j,t} (v \vert x) \}_{v \in \mathcal{V}})$
    \ENDFOR
    \STATE Set $t \leftarrow t + h$
\ENDFOR
\RETURN $X_1$
\end{algorithmic}
\end{algorithm}
不难发现,上述采样算法与flow matching中沿向量场积分是非常类似的。事实上,使用CTMC进行生成的整体思路与flow matching也基本一致,区别只在于驱动概率路径演化的工具从向量场换成了CTMC。
Training CTMC Models
Conditional and Marginal Probability Path
我们可以沿用flow matching中概率路径的框架来理解CTMC模型。离散的条件概率路径是一族分布\(p_t (x \vert z)\),它在\(t=0\)时刻等于初始分布\(p_\text{init}\),而在\(t=1\)时刻收敛到目标样本\(z\):
\[p_0 ( \cdot \vert z ) = p_\text{init}, \quad p_1 ( \cdot \vert z ) = \delta_z\]对应的离散边缘概率路径则通过对数据分布求期望得到:
\[p_t (x) = \sum_z p_t (x \vert z) p_\text{data} (z)\]与flow matching中连续的情形类似,离散概率路径同样可以看作是在两个概率分布之间进行插值。特别地,利用线性插值就可以在任意两个分布之间构造出一条离散概率路径:
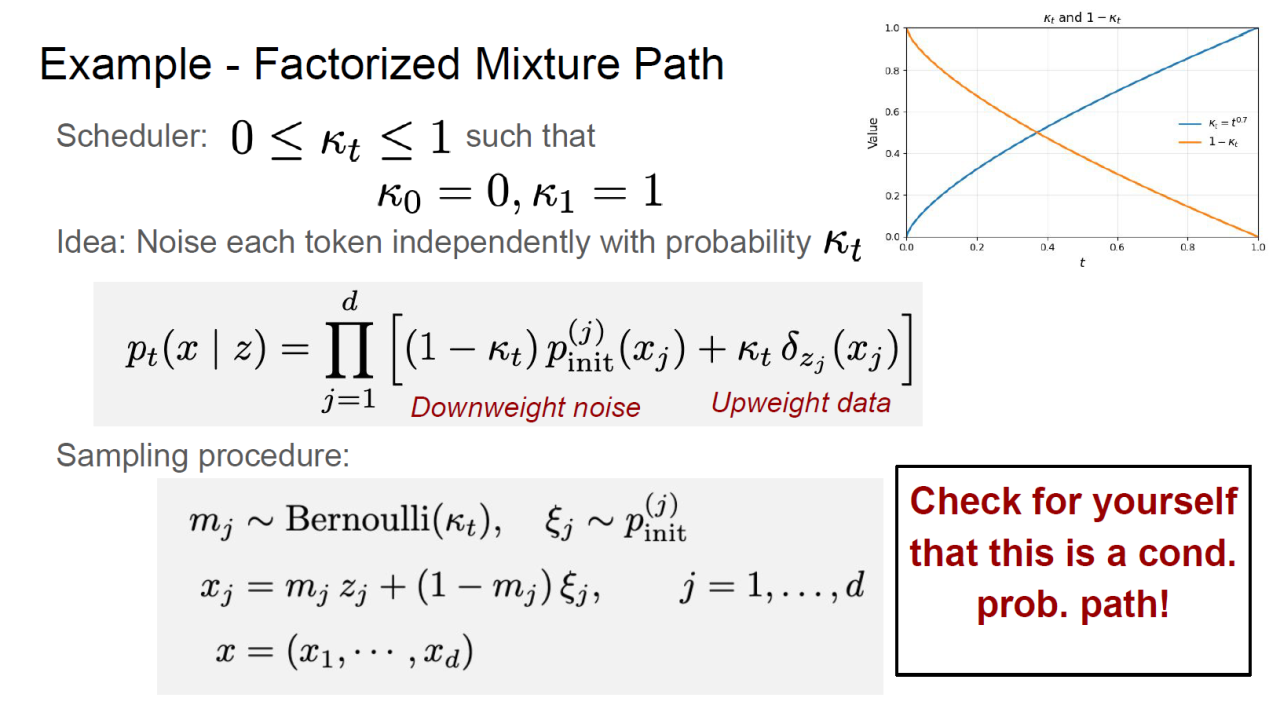
\[p_t (x \vert z) = \prod_{j = 1}^d \left[ (1 - \kappa_t) p_\text{init}^{(j)} (x_j) + \kappa_t \delta_{z_j} (x_j) \right].\]其中\(p_\text{init}^{(j)} (x_j)\)是初始分布在第\(j\)个位置上的边缘分布,\(\delta_{z_j} (x_j)\)把该位置固定为目标样本的第\(j\)个token,而\(\kappa_t\)则是从0增长到1的插值系数,称为scheduler,它满足
\[\kappa_0 = 0, \quad \kappa_1 = 1\]对于线性插值这一最简单的情形,可以直接取
\[\kappa_t = t\]\(\kappa_t\)相当于一个mask:以概率\(\kappa_t\)保留目标数据token,否则用初始分布采样出的噪声token填充。在每个位置独立地做这样的混合,就得到了对应的概率路径,称为factorized mixture path。
Conditional and Marginal Rate Matrix
在离散情形下,驱动概率路径演化的是CTMC,其地位相当于连续情形中的向量场。对于给定的目标样本\(z\),我们把驱动条件概率路径\(p_t (\cdot \vert z)\)的CTMC所对应的速率矩阵记为\(Q_t^z (y \vert x)\),称为条件速率矩阵(conditional rate matrix):从\(t = 0\)时刻的\(p_\text{init}\)出发执行CTMC采样,即可演化到任意时刻的条件分布\(p_t (\cdot \vert z)\)。
类似于flow matching中的边缘化技巧,我们也可以对rate matrix做同样的边缘化,由此构造出marginal rate matrix:
\[Q_t (y \vert x) = \sum_{z \in S} Q_t^z (y \vert x) \frac{p_t (x \vert z) p_\text{data} (z)}{p_t (x)} = \sum_{z \in S} Q_t^z (y \vert x) p_{1 \vert t} (z \vert x)\]其中\(p_{1 \vert t} (z \vert x) \coloneqq \frac{p_t (x \vert z) p_\text{data} (z)}{p_t (x)}\)可以理解为"已知\(t\)时刻状态为\(x\)时,原始数据为\(z\)"的后验概率。我们希望这样构造出的marginal rate matrix恰好驱动着边缘概率路径\(p_t\)的演化,从而把初始分布\(p_\text{init}\)变换为目标分布\(p_\text{data}\);这一点将在下面给出证明。
类似于flow matching中的连续性方程,CTMC中概率分布随时间的演化则由Kolmogorov前向方程(Kolmogorov forward equation, KFE)来描述。它给出了概率路径\(p_t\)与驱动它的rate matrix\(Q_t\)之间的相容条件:当且仅当满足下式时,\(Q_t\)所对应的CTMC恰好把分布沿着\(p_t\)演化。
\[\frac{\mathrm{d}}{\mathrm{d}t} p_t (x) = \sum_{y \in S} Q_t (x \vert y) p_t (y)\]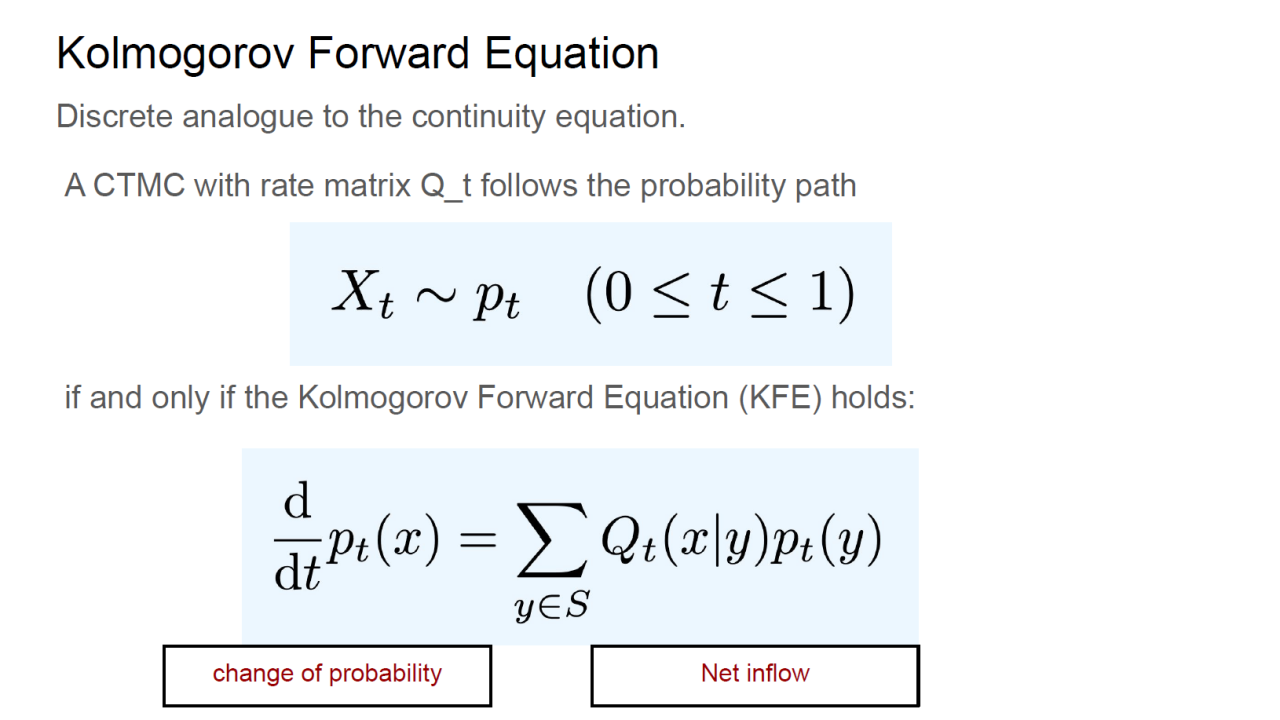
下面利用KFE来证明rate matrix的边缘化技巧。首先由全概率公式展开\(p_t (x)\),并交换求导与求和操作:
\[\frac{\mathrm{d}}{\mathrm{d}t} p_t (x) = \frac{\mathrm{d}}{\mathrm{d}t} \sum_{z \in S} p_t (x \vert z) p_\text{data} (z) = \sum_{z \in S} \frac{\mathrm{d}}{\mathrm{d}t} p_t (x \vert z) \, p_\text{data} (z)\]接着对条件路径\(p_t (\cdot \vert z)\)使用KFE,即\(\frac{\mathrm{d}}{\mathrm{d}t} p_t (x \vert z) = \sum_{y \in S} Q_t^z (x \vert y) \, p_t (y \vert z)\)。把它代入上式并交换对\(y\)、\(z\)的求和次序:
\[\begin{aligned} \frac{\mathrm{d}}{\mathrm{d}t} p_t (x) &= \sum_{z \in S} \left[ \sum_{y \in S} Q_t^z (x \vert y) \, p_t (y \vert z) \right] p_\text{data} (z) \\ &= \sum_{y \in S} p_t (y) \left[ \sum_{z \in S} Q_t^z (x \vert y) \, \frac{p_t (y \vert z) p_\text{data} (z)}{p_t (y)} \right] \end{aligned}\]方括号中的部分正是marginal rate matrix按后验概率\(p_{1 \vert t} (z \vert y) = \frac{p_t (y \vert z) p_\text{data} (z)}{p_t (y)}\)的加权平均。把它记为
\[Q_t (x \vert y) \coloneqq \sum_{z \in S} Q_t^z (x \vert y) \frac{p_t (y \vert z) p_\text{data} (z)}{p_t (y)} = \sum_{z \in S} Q_t^z (x \vert y) \, p_{1 \vert t} (z \vert y)\]这与前面构造的marginal rate matrix完全一致。把它代回上式,就得到边缘概率路径的KFE:
\[\frac{\mathrm{d}}{\mathrm{d}t} p_t (x) = \sum_{y \in S} Q_t (x \vert y) p_t (y)\]这说明按后验加权平均得到的marginal rate matrix确实驱动着边缘概率路径\(p_t\)的演化。
对于factorized mixture path,我们还可以利用KFE构造出对应的conditional rate matrix。根据因子分解的假定,各位置上的演化是相互独立的,因此只需考察单个位置的情形(相当于把序列长度取为1),此时\(p_t (x \vert z) = (1 - \kappa_t) p_\text{init} (x) + \kappa_t \delta_z (x)\)。对它求导有:
\[\begin{aligned} \frac{\mathrm{d}}{\mathrm{d}t} p_t (x \vert z) &= \frac{\mathrm{d}}{\mathrm{d}t} \left[ (1 - \kappa_t) p_\text{init} (x) + \kappa_t \delta_z (x) \right] \\ &= \dot{\kappa}_t \delta_z (x) - \dot{\kappa}_t p_\text{init} (x) \end{aligned}\]对右端做代数变形:分子分母同乘\(1 - \kappa_t\),即可凑出概率路径\(p_t (x \vert z)\)本身;最后一步利用\(\delta_z (x) \in \{0, 1\}\),把结果拆成"跳到目标词"与"保持不动"两项:
\[\begin{aligned} \dot{\kappa}_t \delta_z (x) - \dot{\kappa}_t p_\text{init} (x) &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \Big( \delta_z (x) - \big[ (1 - \kappa_t) p_\text{init} (x) + \kappa_t \delta_z (x) \big] \Big) \\ &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_z (x) - p_t (x \vert z) \big) \\ &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \delta_z (x) \big( 1 - p_t (x \vert z) \big) + \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_z (x) - 1 \big) p_t (x \vert z) \end{aligned}\]其中第一项中的\(1 - p_t (x \vert z)\)可以利用概率归一性\(\sum_{y \in S} p_t (y \vert z) = 1\)改写为对其余状态的求和:
\[1 - p_t (x \vert z) = \sum_{y \neq x} p_t (y \vert z)\]代入之后,第一项就变成了对\(y \neq x\)的求和:
\[\frac{\mathrm{d}}{\mathrm{d}t} p_t (x \vert z) = \sum_{y \neq x} \frac{\dot{\kappa}_t}{1 - \kappa_t} \delta_z (x) \, p_t (y \vert z) + \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_z (x) - 1 \big) p_t (x \vert z)\]其中第二项对应\(y = x\)即状态保持不变的情形。借助\(\delta_x (y)\)可以把两项写成统一的形式并合并,最终得到条件概率路径的KFE以及对应的conditional rate matrix
\[\begin{aligned} \frac{\mathrm{d}}{\mathrm{d}t} p_t (x \vert z) &= \sum_{y \neq x} \frac{\dot{\kappa}_t}{1 - \kappa_t} \delta_z (x) \, p_t (y \vert z) + \sum_{y = x} \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_z (y) - 1 \big) p_t (y \vert z) \\ &= \sum_{y \in S} \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_z (x) - \delta_x (y) \big) \, p_t (y \vert z) \\ &= \sum_{y \in S} Q_t^z (x \vert y) \, p_t (y \vert z) \end{aligned}\]把它逐位置应用,就得到conditional rate matrix的完整表达式:
\[\begin{aligned} Q_t^z (v_i, j \vert x) &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_{z_j} (v_i) - \delta_{x_j} (v_i) \big) \\ &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \begin{cases} 0 & \text{if } x_j = z_j \\ 1 & \text{if } v_i = z_j,\ x_j \neq z_j \\ 0 & \text{if } v_i \neq z_j,\ x_j \neq z_j \\ -1 & \text{if } v_i = x_j,\ x_j \neq z_j \end{cases} \end{aligned}\]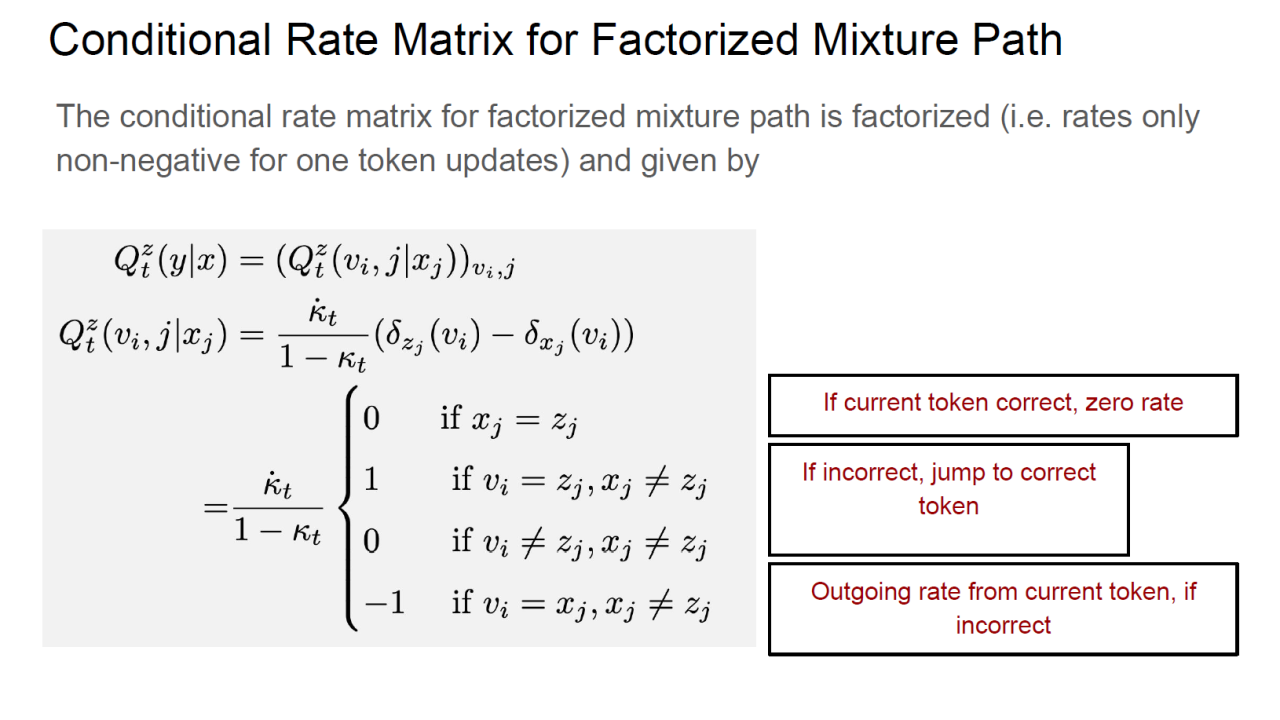
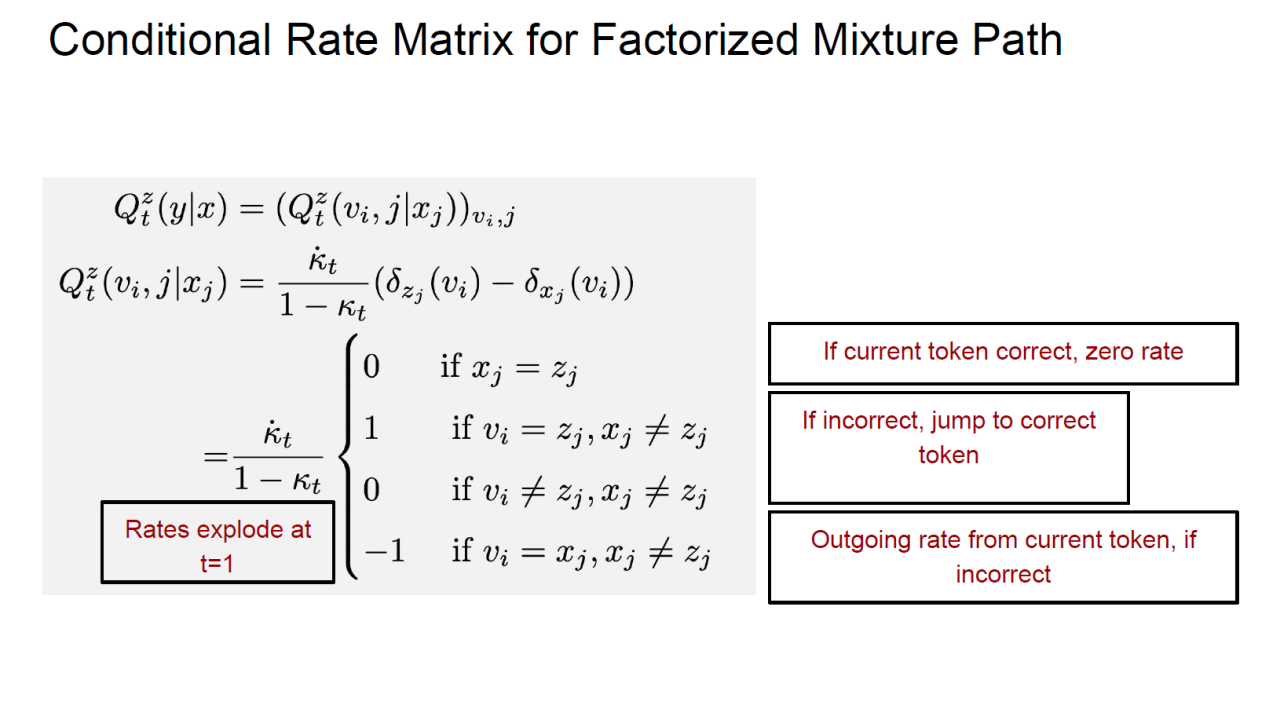
把上式代入边缘化公式,就得到对应的marginal rate matrix:
\[\begin{aligned} Q_t (v_i, j \vert x) &= \sum_{z \in S} Q_t^z (v_i, j \vert x) \, p_{1 \vert t} (z \vert x) \\ &= \sum_{z \in S} \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( \delta_{z_j} (v_i) - \delta_{x_j} (v_i) \big) p_{1 \vert t} (z \vert x) \\ &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \left( \sum_{z \in S} \delta_{z_j} (v_i) \, p_{1 \vert t} (z \vert x) - \delta_{x_j} (v_i) \sum_{z \in S} p_{1 \vert t} (z \vert x) \right) \\ &= \frac{\dot{\kappa}_t}{1 - \kappa_t} \big( p_{1 \vert t} (z_j = v_i \vert x) - \delta_{x_j} (v_i) \big) \end{aligned}\]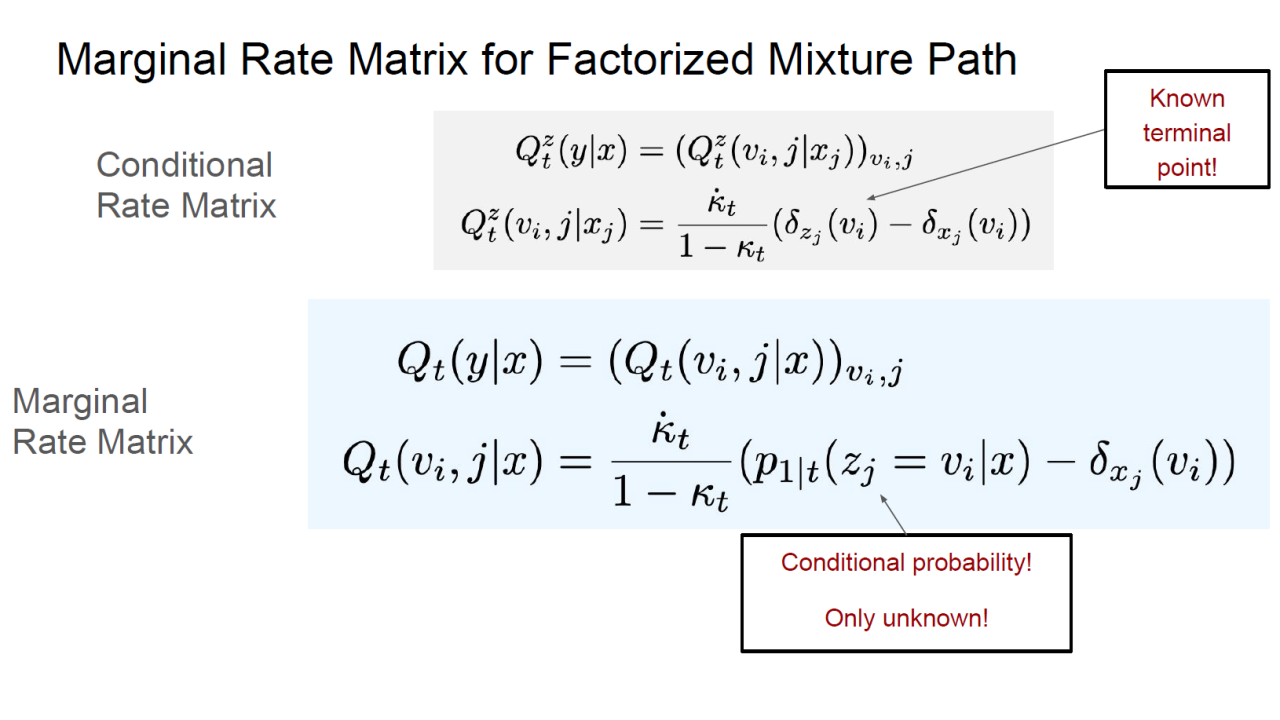
注意到marginal rate matrix中唯一未知的就是条件概率\(p_{1 \vert t} (z_j = v_i \vert x)\),因此只要用网络把它学习出来,就可以得到完整的CTMC模型。而这一条件概率本质上就是一个在词表上的分类器——它要对每个位置预测该位置的真实token,因此直接使用通常的交叉熵损失即可完成训练。这样得到discrete flow matching的损失函数:
\[\mathcal{L}_\text{DFM} (\theta) = \mathbb{E}_{z \sim p_\text{data},\, t \sim \text{Unif}_{[0, 1]},\, x \sim p_t ( \cdot \vert z)} \left[ \sum_{j = 1}^d - \log p_{1 \vert t}^{\theta} (z_j \vert x) \right]\]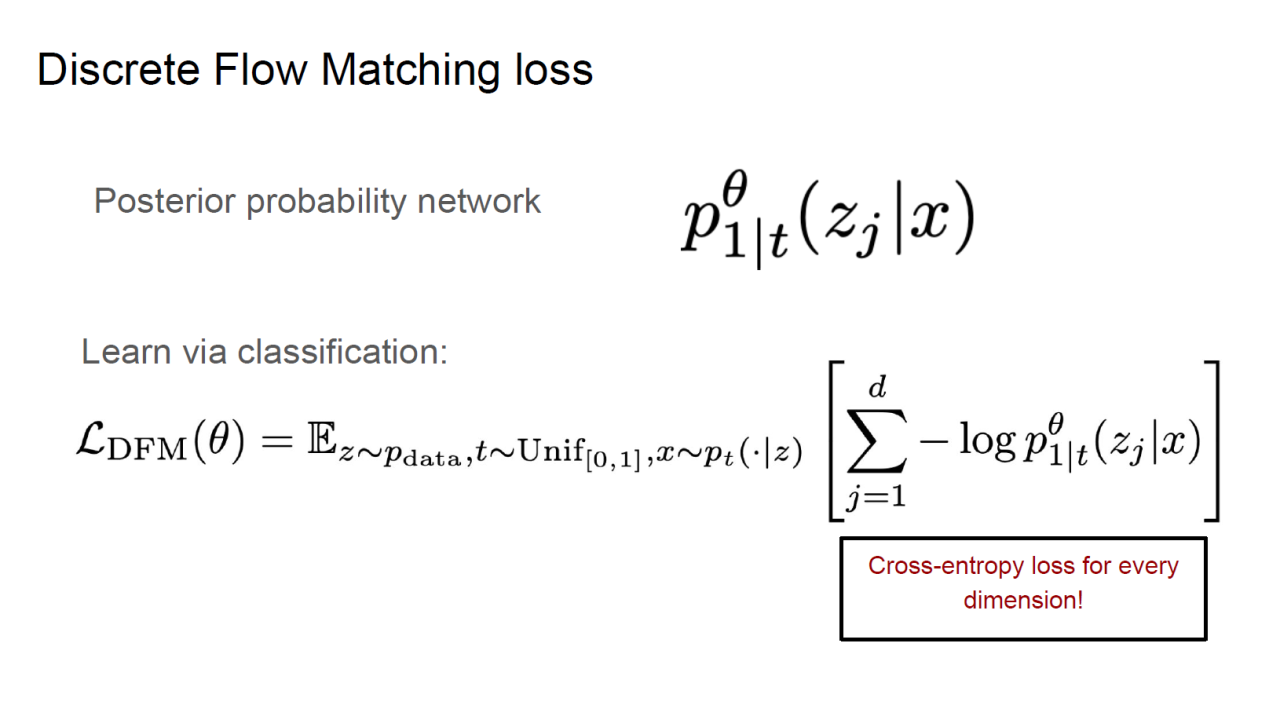
整理一下,得到CTMC模型的训练算法如下:
\begin{algorithm}
\caption{Training Factorized CTMC Model (Discrete Diffusion)}
\begin{algorithmic}
\REQUIRE Dataset of sequences $z \sim p_{\text{data}}$ with $z = (z_1, \dots, z_d) \in \mathcal{V}^d$; initial (noise) token marginals $p_{\text{init}}^{(j)}$ on $\mathcal{V}$; schedule $\kappa_t \in [0, 1]$; posterior network $f_\theta$ returning per-position logits over $\mathcal{V}$; optimizer Opt
\FOR{each training iteration}
    \STATE Sample a data point $z \sim p_{\text{data}}$
    \STATE Sample time $t \sim \text{Unif}[0, 1]$ and compute $\kappa \leftarrow \kappa_t$
    \STATE Sample a noisy state $x \sim p_t ( \cdot \vert z )$ (factorized mixture path):
    \FOR{$j = 1, \dots, d$ (in parallel)}
        \STATE Sample mask $m_j \sim \text{Bernoulli}(\kappa)$
        \STATE Sample noise token $\xi_j \sim p_{\text{init}}^{(j)}$
        \STATE Set $x_j \leftarrow m_j z_j + (1 - m_j) \xi_j$
    \ENDFOR
    \STATE $x \leftarrow (x_1, \dots, x_d)$
    \STATE Predict terminal-token posteriors via logits from the network: $\ell_j ( \cdot ) \leftarrow f_\theta (x, t)_j \ \Rightarrow \ p_{1 \vert t}^{\theta} (v \vert x)_j = \text{Softmax} ( \ell_j ) (v)$
    \STATE Discrete Flow Matching loss (token-wise NLL of $z$): $\mathcal{L}_{\text{DFM}} ( \theta ) \leftarrow \sum_{j = 1}^d \big[ - \log p_{1 \vert t}^{\theta} ( z_j \vert x )_j \big]$
    \STATE Update parameters: $\theta \leftarrow \text{Opt.Step} ( \nabla_\theta \mathcal{L}_{\text{DFM}} ( \theta ) )$
\ENDFOR
\end{algorithmic}
\end{algorithm}
Debate and Future Directions
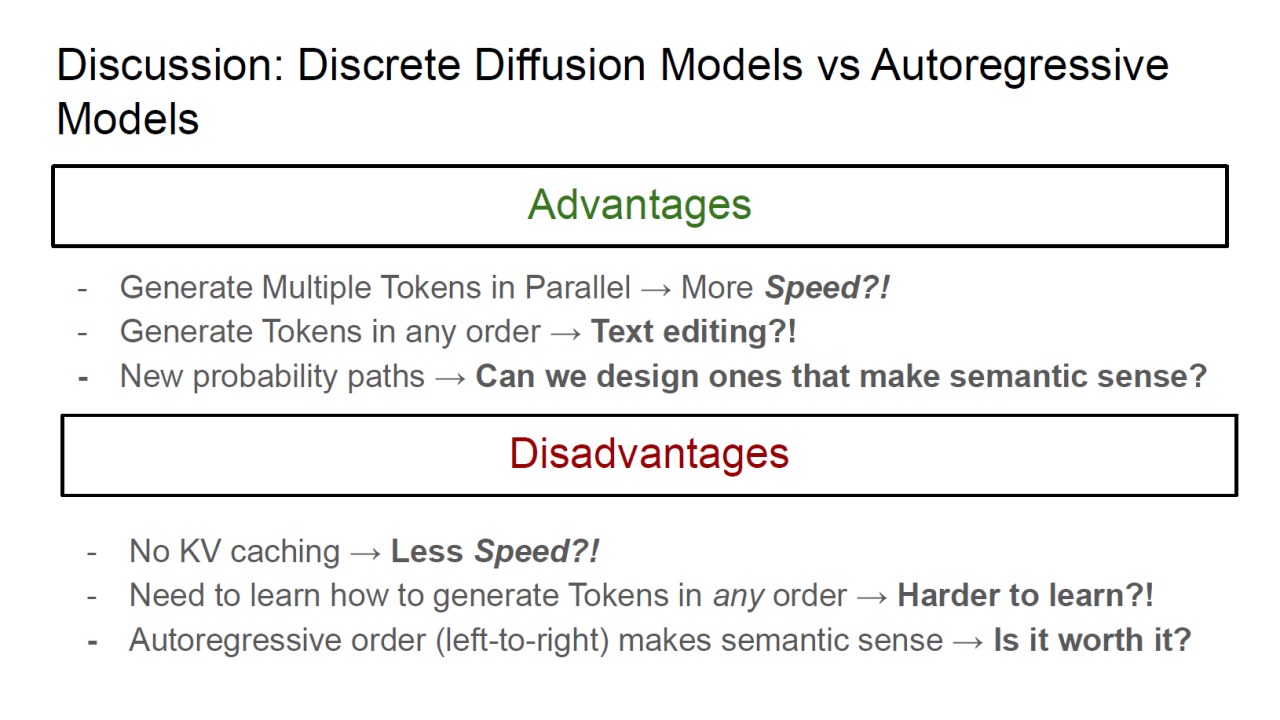
与当前LLM普遍采用的自回归模型相比,离散扩散模型目前仍更像是一种探索性的技术:它的性能尚不及自回归模型,训练难度也相对更高,因此距离大规模实用还有不少问题需要进一步研究。
如果对flow matching以及CTMC模型的底层数学框架更感兴趣,可以参考Generator Matching的相关理论。