MIT 6.S184课程笔记2-Flow Matching
这个系列是MIT 6.S184 - Introduction to Flow Matching and Diffusion Models的同步课程笔记。本门课程面向希望深入理解流模型与扩散模型的学生和研究者,从最基础的数学工具出发,逐步推导这些模型背后的数学原理,并介绍相应的训练与采样算法。本节课主要介绍Flow Matching算法背后的数学原理。
在上一节课中,我们基于ODE和SDE介绍了流模型与扩散模型的基本框架。从生成数据的流程上看,流模型和扩散模型都需要从一个给定的初始分布\(p_{\text{init}}\)出发,沿着由神经网络表示的向量场\(u_t^\theta (X_t)\)对轨迹进行积分,从而实现数据生成。二者的差异在于积分过程中是否需要考虑扩散系数\(\sigma_t\),因此流模型可以看作是扩散模型的一个特例。
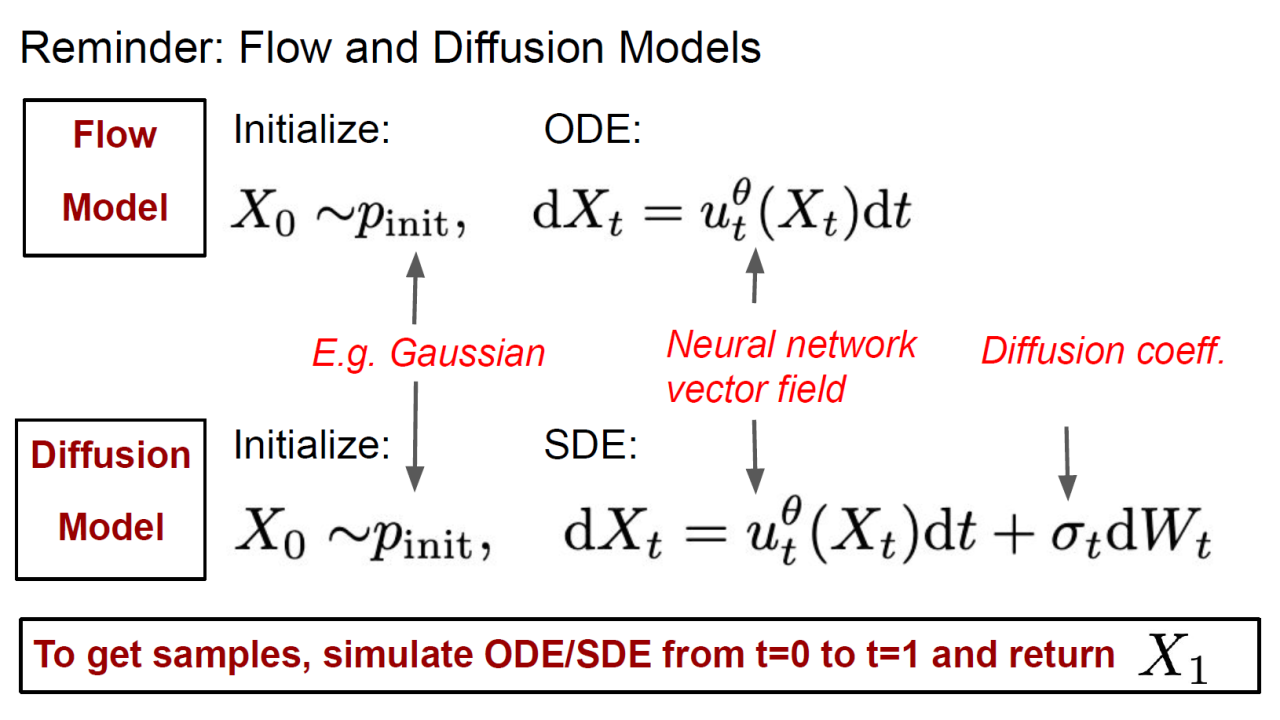
本节课我们将介绍流模型中向量场\(u_t^\theta (X_t)\)的训练方法,并从数学角度推导flow matching算法。
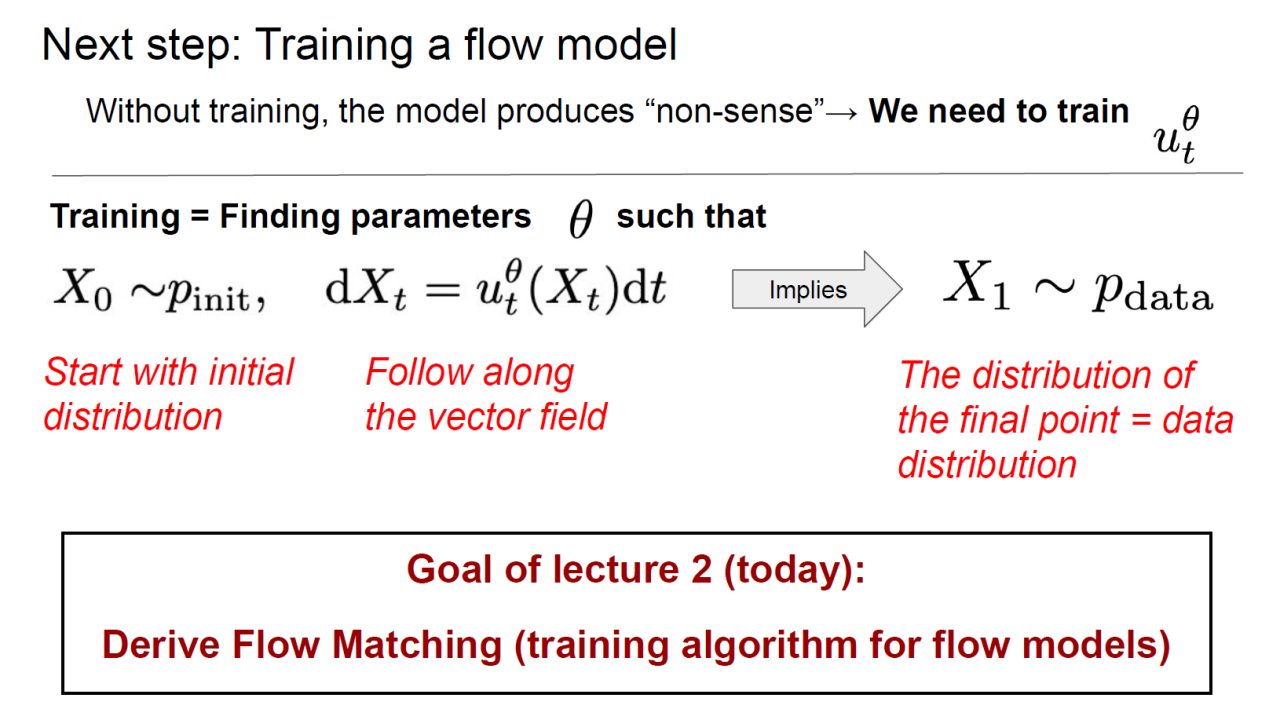
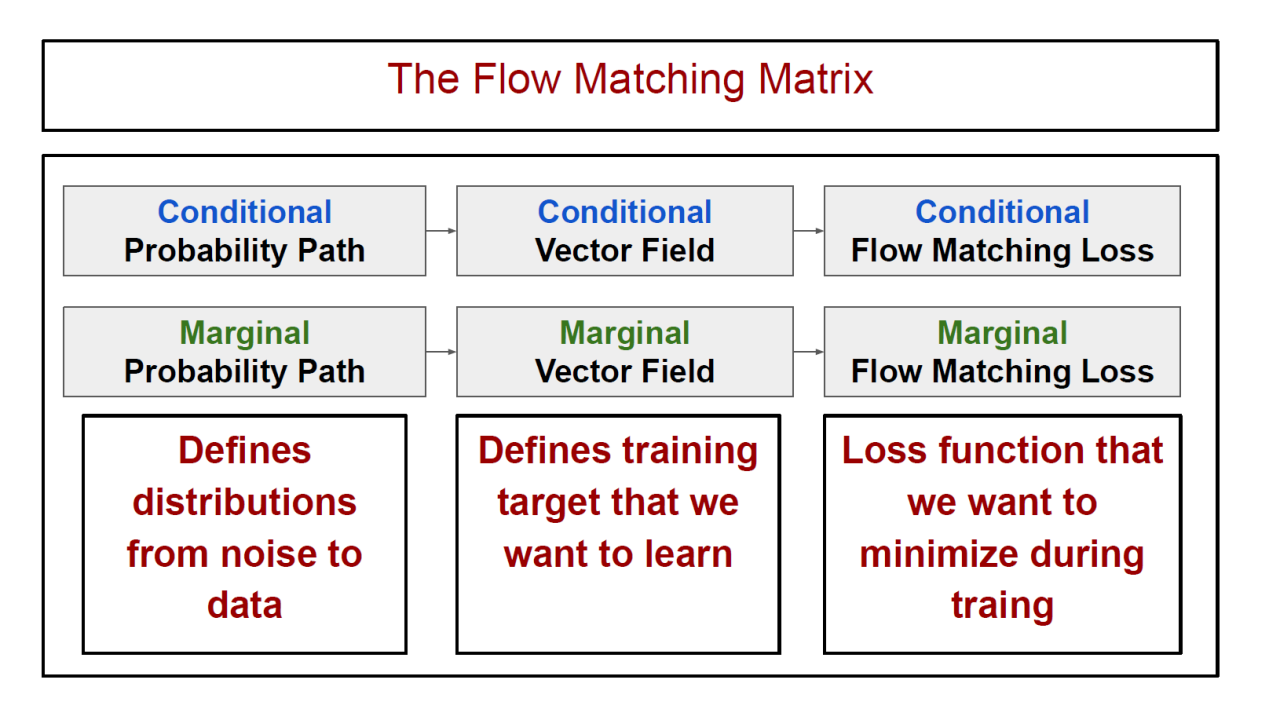
从整体来看,flow matching算法涉及三个核心概念,分别是概率路径(probability path)、向量场(vector field)和损失函数(loss)。对于这三个概念,我们还需要从条件概率(conditional probability)和边缘概率(marginal probability)两个视角分别进行分析:条件概率视角针对单个数据样本,而边缘概率视角则针对整个数据分布。
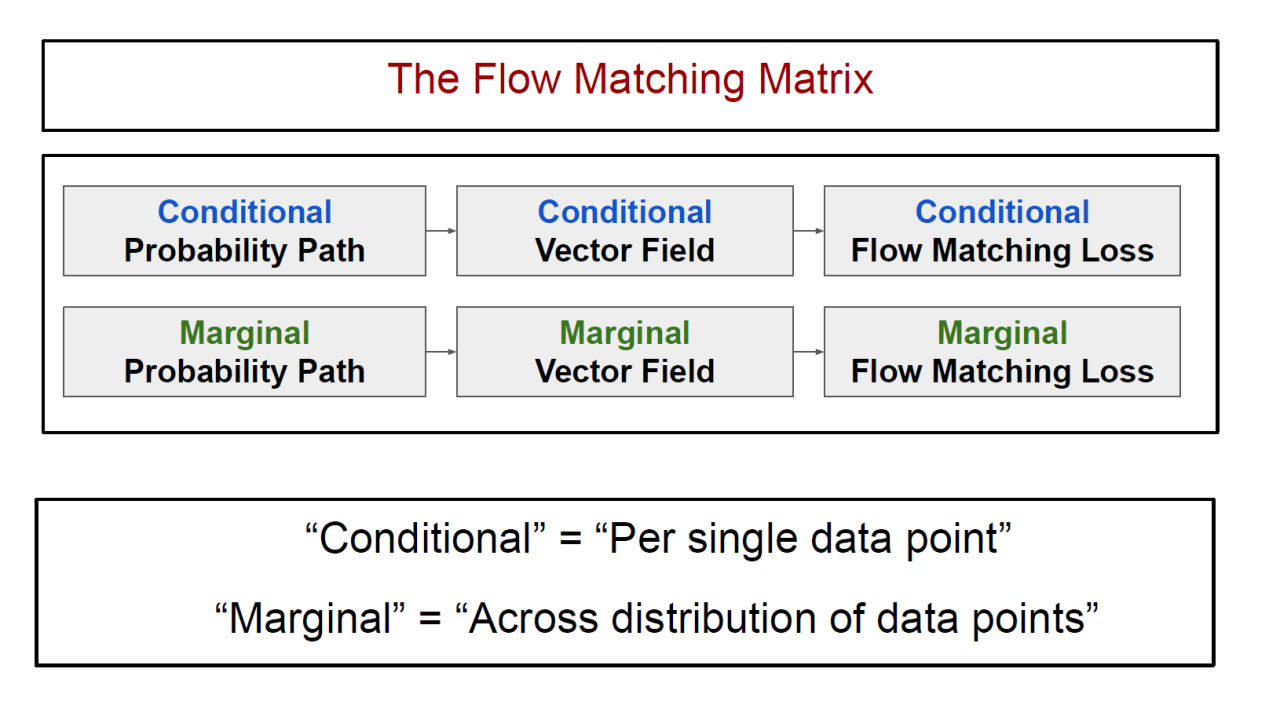
Probability Path
概率路径(probability path)描述了从初始分布\(p_{\text{init}}\)到数据分布\(p_{\text{data}}\)的转移过程。在\(t=0\)时刻它对应初始分布中的噪声,而在\(t=1\)时刻则对应真实的数据样本。
Conditional Probability Path
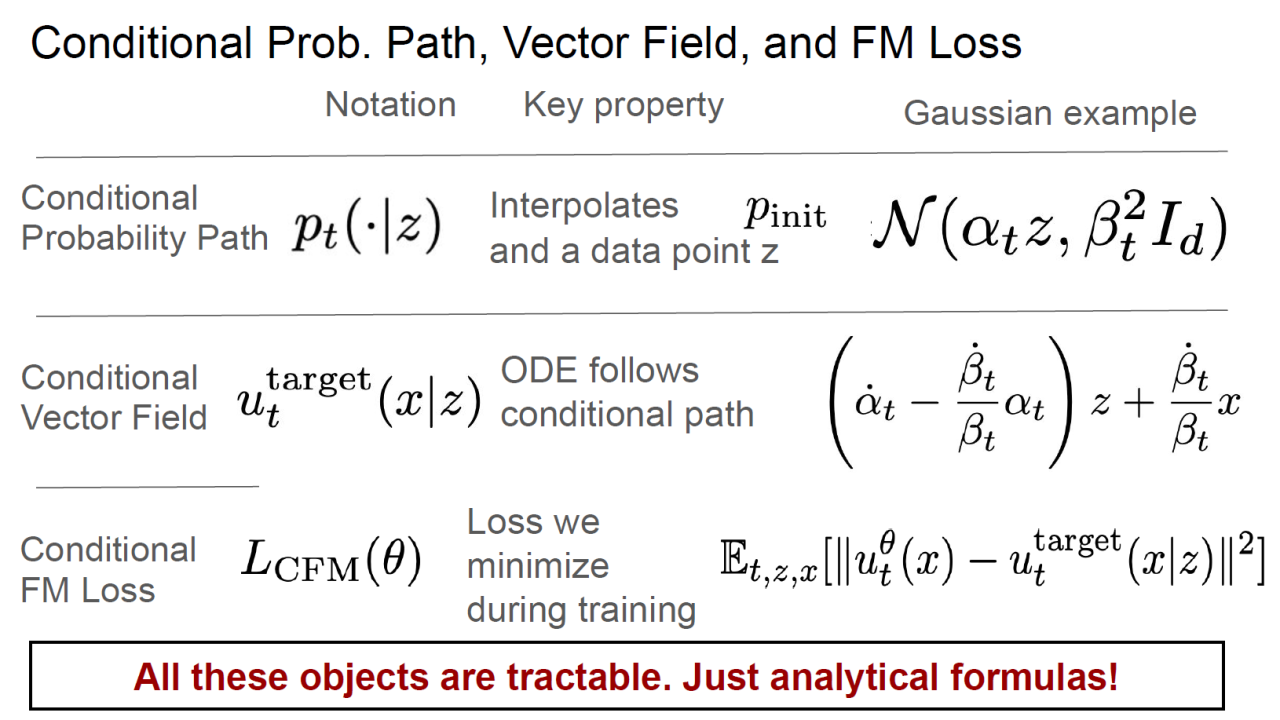
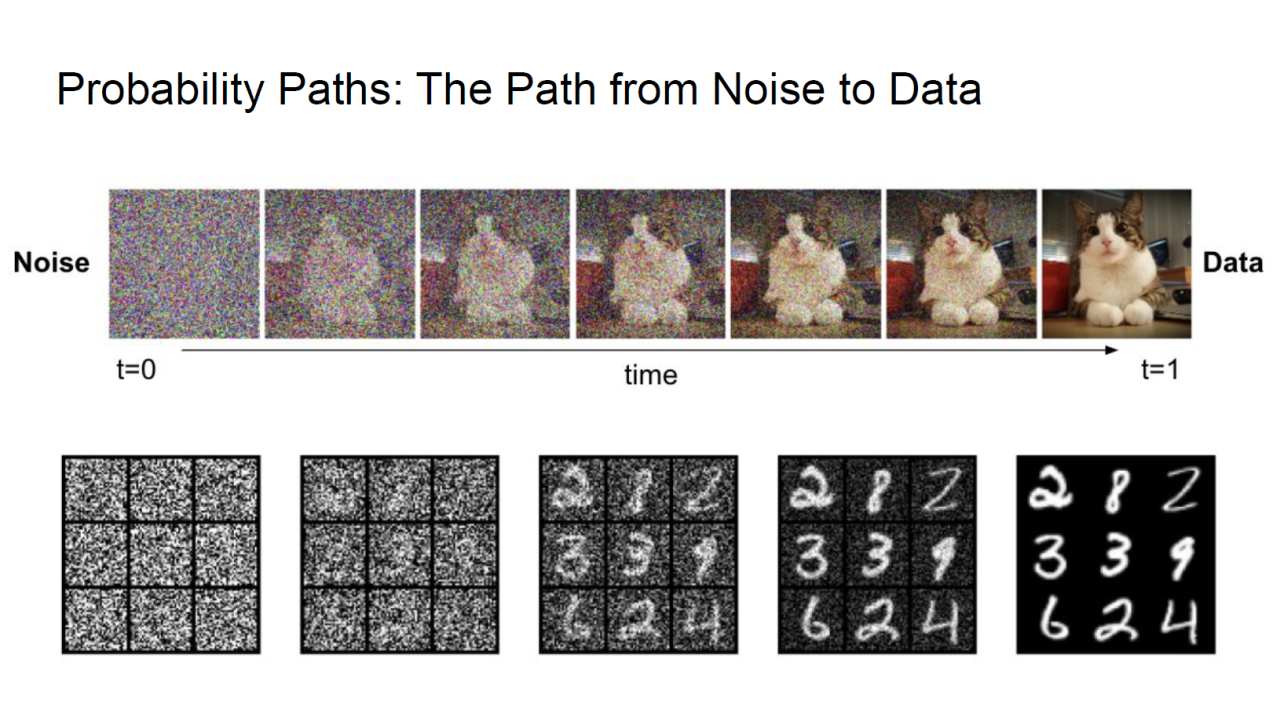
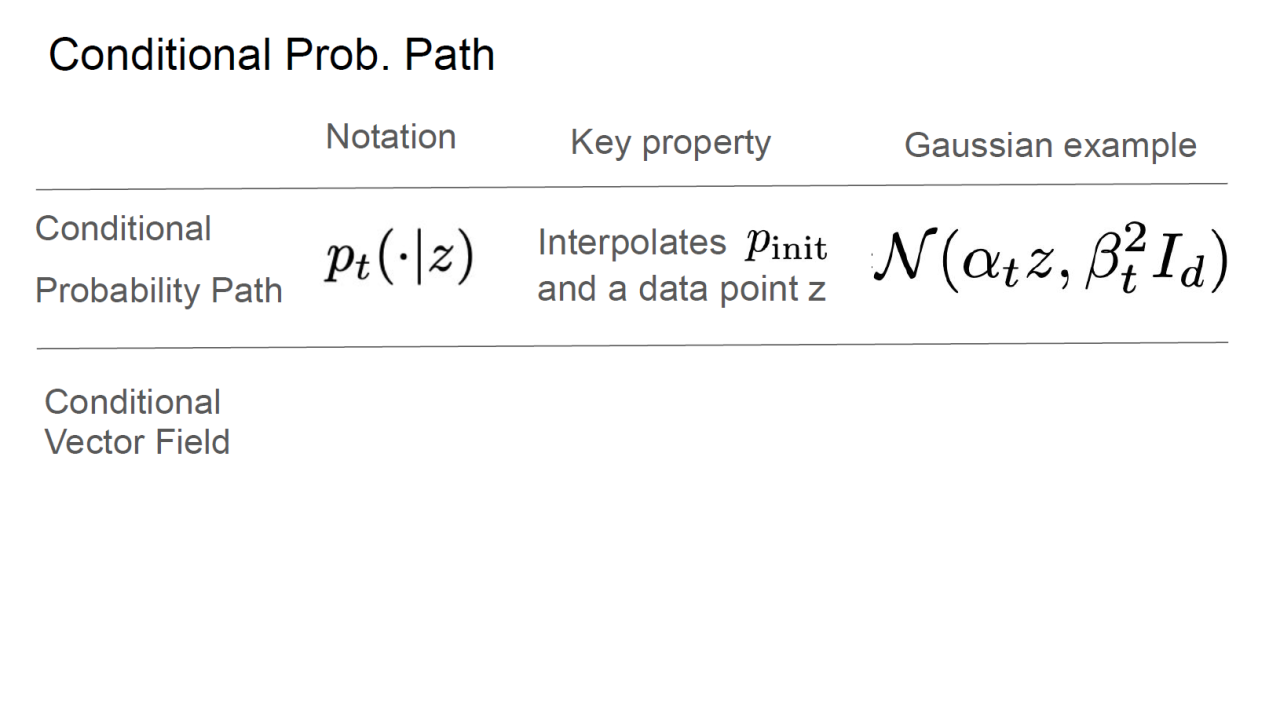
接下来我们定义条件概率路径(conditional probability path) \(p_t (x \vert z)\) 为满足如下条件的概率分布:
- 在\(t=0\)时刻等价于初始分布\(p_0 (\cdot \vert z) = p_{\text{init}}\),且与样本数据\(z\)无关
- 在\(t=1\)时刻收敛到样本数据\(z\)上,即\(p_1 (\cdot \vert z) = \delta_z\)
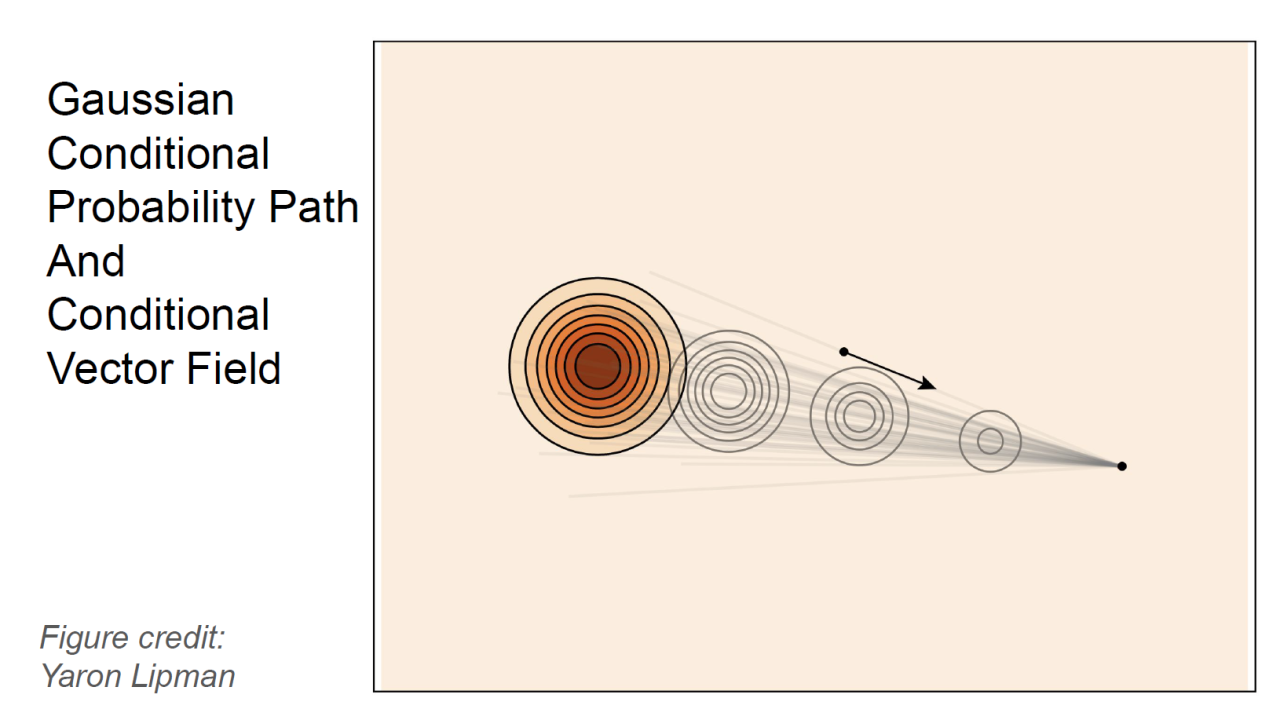
我们可以参考下图来理解上述条件概率路径:初始分布\(p_{\text{init}}\)随着时间推移,最终集中到样本数据\(z\)处。
Marginal Probability Path
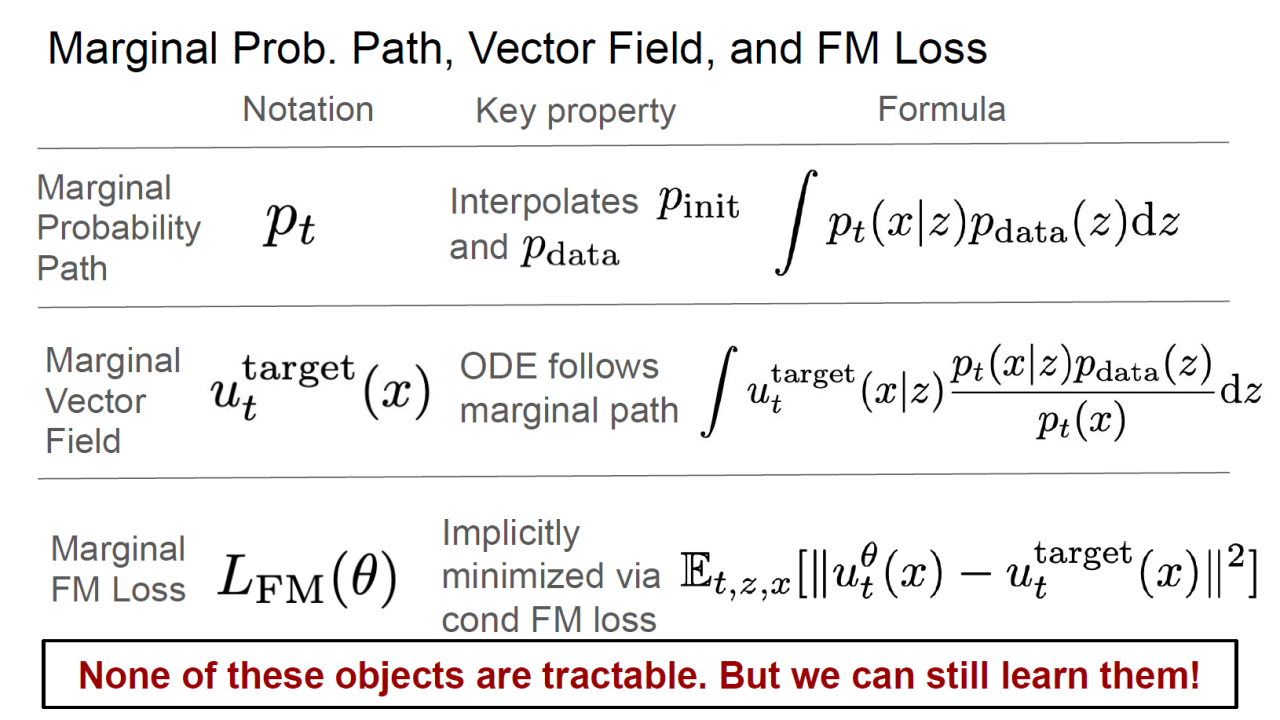
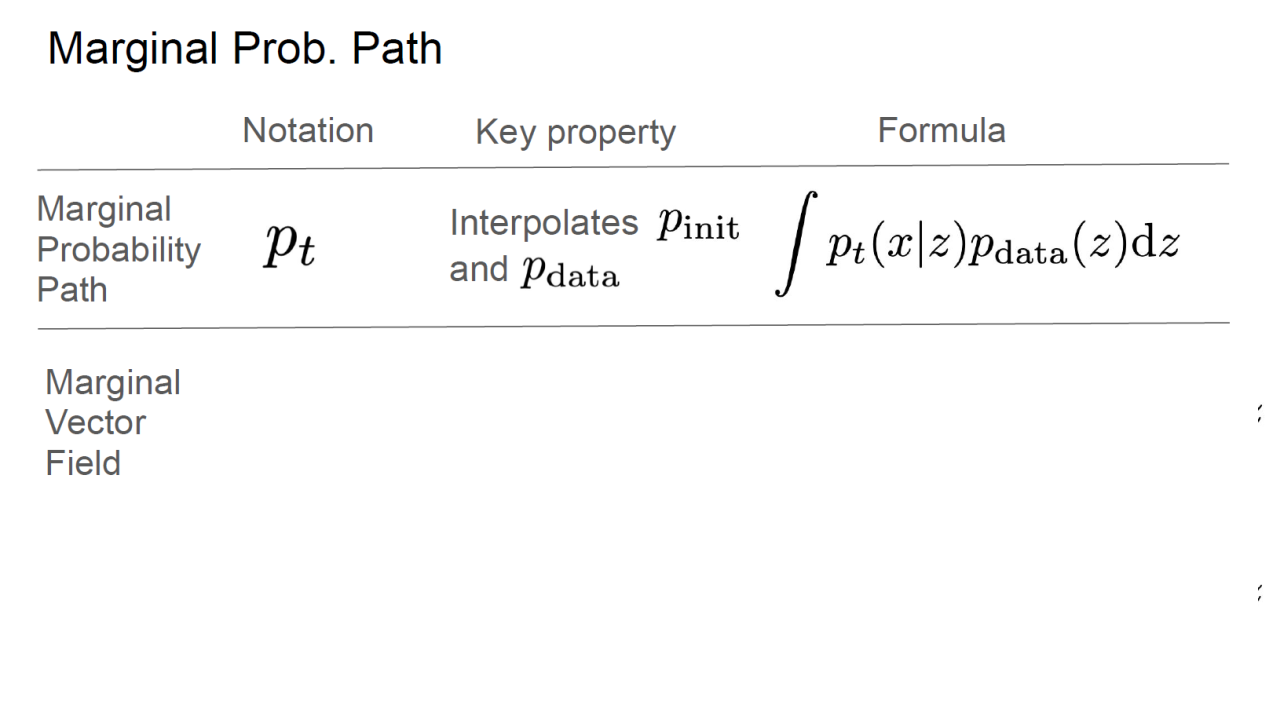
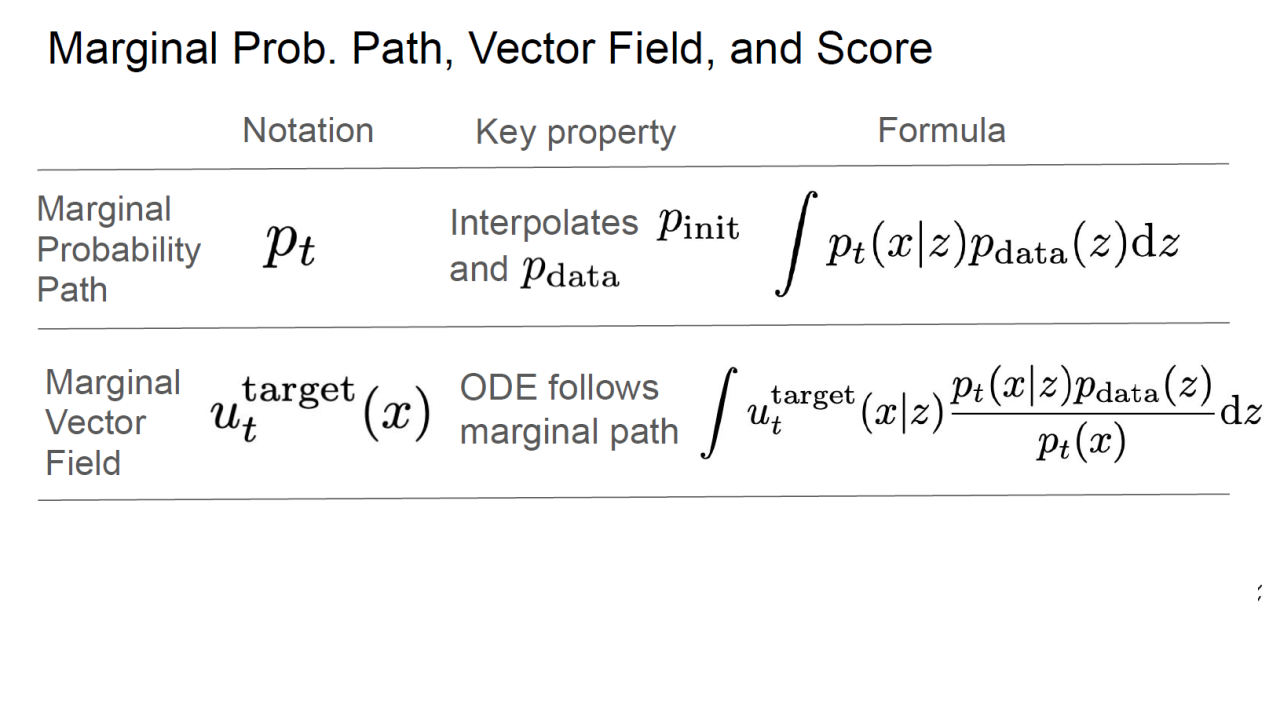
在条件概率路径的基础上,我们可以定义边缘概率路径(marginal probability path),它描述了从初始分布到整个数据分布的变换过程。根据联合概率密度公式,边缘概率路径\(p_t (x)\)可以表示为
\[p_t (x) = \int p_t (x \vert z) \ p_{\text{data}} (z) \ \mathrm{d} z\]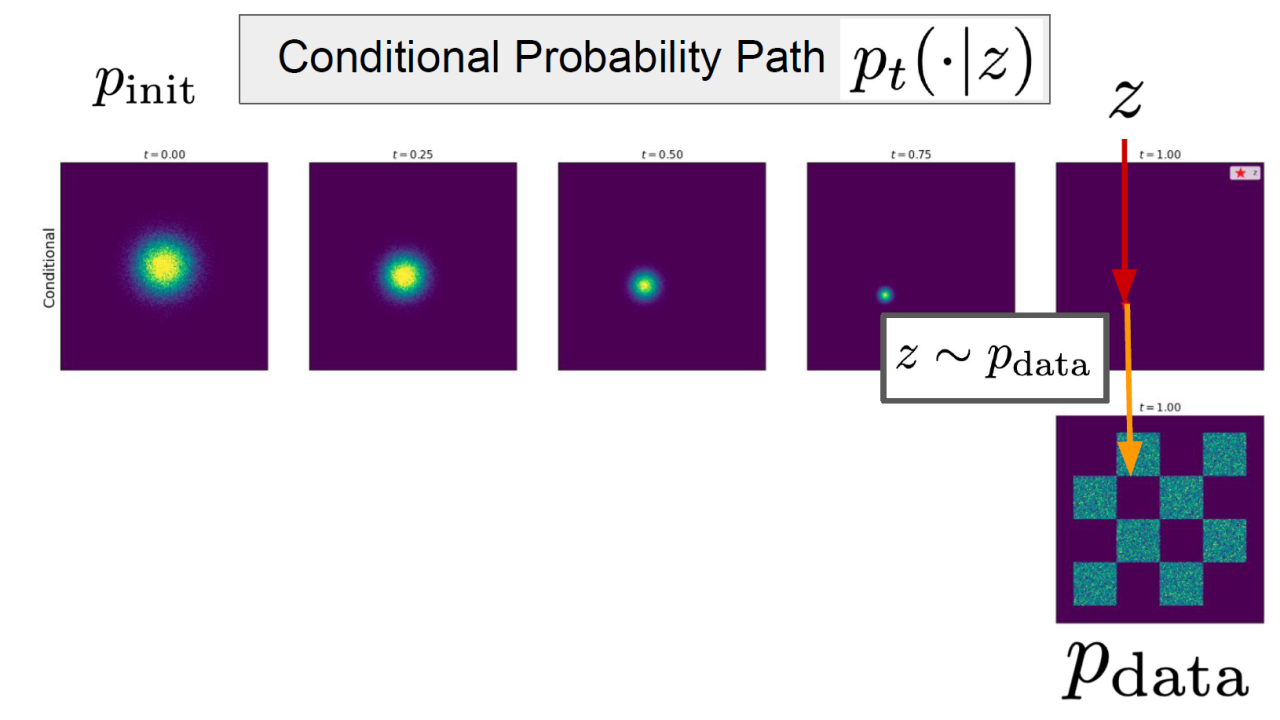
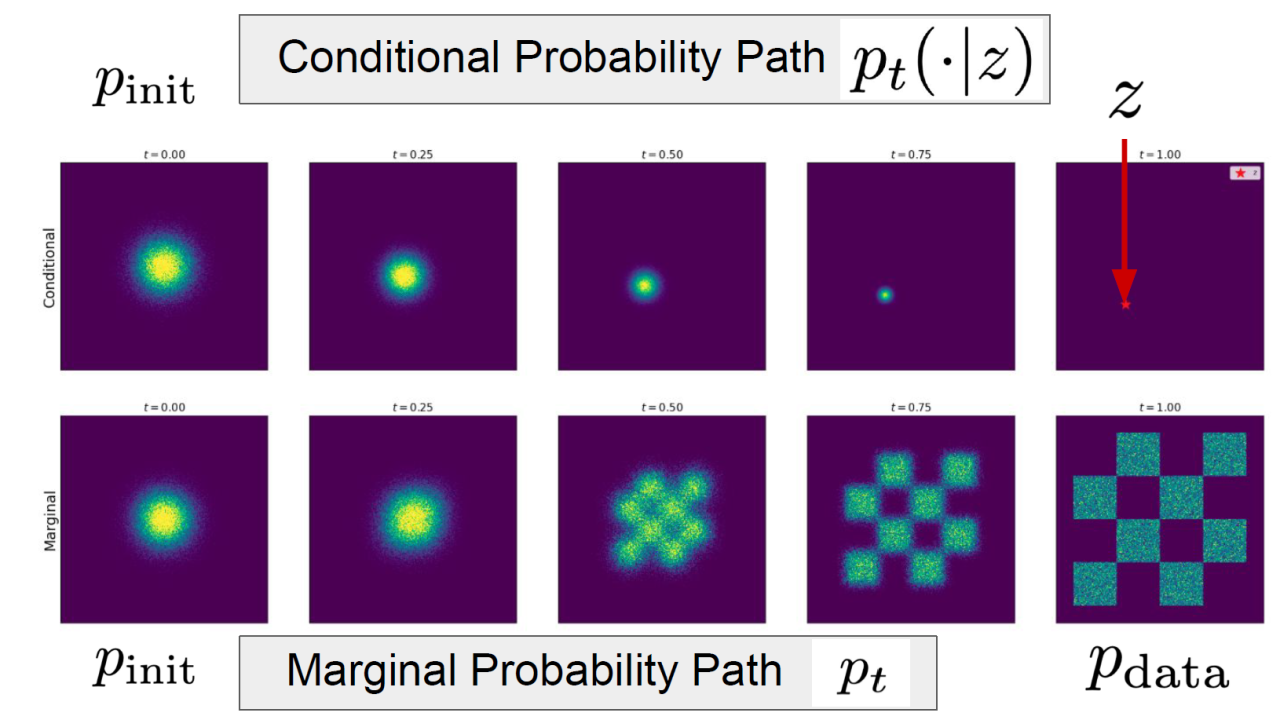
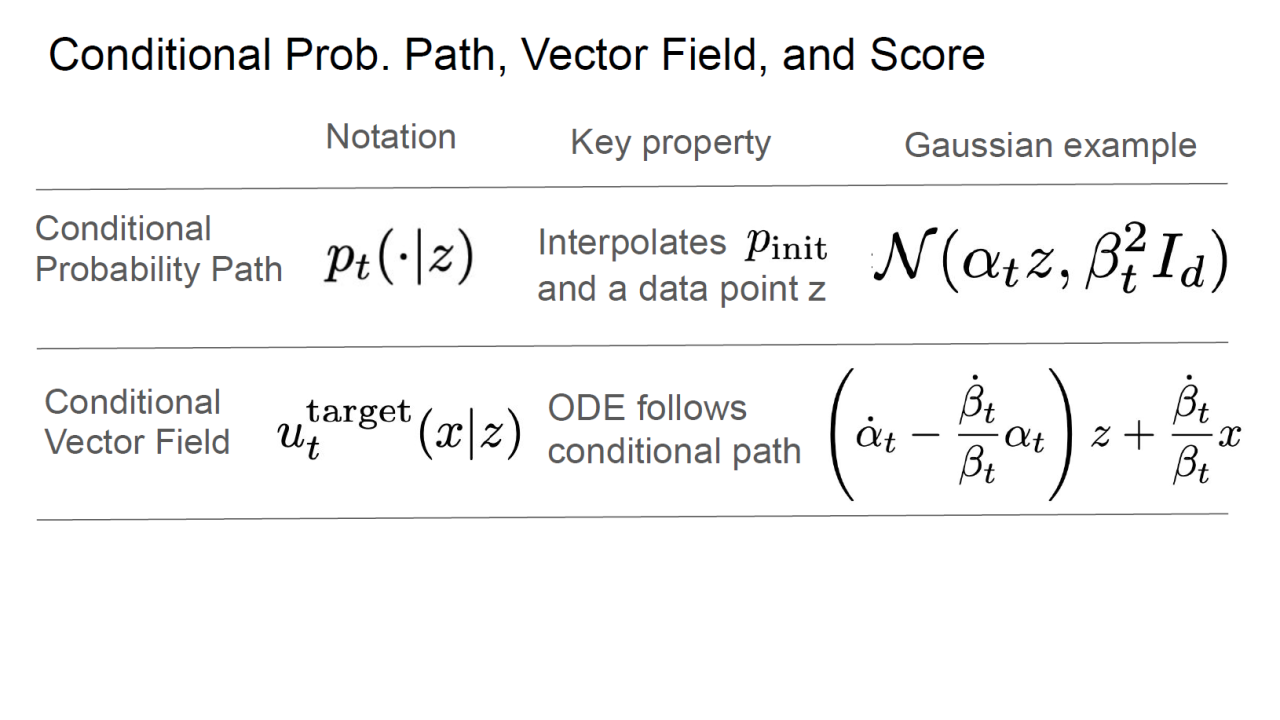
条件概率路径和边缘概率路径之间的关系可以总结如下:
Gaussian Probability Path
在生成模型中,有一类重要的条件概率路径称为高斯概率路径(Gaussian probability path),它描述了从标准正态分布\(\mathcal{N} (0, I_d)\)到样本数据\(p_{\text{data}}\)的转移过程。我们首先定义高斯条件概率路径(Gaussian conditional probability path)为:
\[p_t (x \vert z) \sim \mathcal{N} (\alpha_t z, \beta_t^2 I_d)\]上式的两个参数\(\alpha_t\)和\(\beta_t\)称为噪声调度(noise scheduler),需要满足以下条件
\[\alpha_0 = \beta_1 = 0, \quad \alpha_1 = \beta_0 = 1\]容易验证,高斯条件概率路径满足条件概率路径的定义:
\[p_0 (\cdot \vert z) \sim \mathcal{N} (0, I_d), \quad p_1 (\cdot \vert z) \sim \delta_z\]高斯概率路径的一个重要性质在于,我们可以利用正态分布的性质方便地从边缘概率路径中采样。具体来说,对于样本数据\(z \sim p_{\text{data}}\),从边缘分布中采样可以表示为:
\[x_t = \alpha_t z + \beta_t \epsilon_t \sim p_t\]其中\(\epsilon_t \sim \mathcal{N} (0, I_d)\)。上式表明,高斯概率路径可以看作是对样本数据\(\alpha_t z\)逐步添加高斯噪声\(\beta_t \epsilon_t\)的过程。
Vector Field
接下来的问题是如何设计向量场,使得样本轨迹能够沿着我们期望的概率路径变换到数据分布上。
Conditional Vector Field
记条件向量场(conditional vector field)为\(u_t^\text{target} (\cdot \vert z)\),它对应条件概率路径\(p_t (x \vert z)\),即满足如下ODE
\[\frac{\mathrm{d}}{\mathrm{d} t} X_t = u_t^\text{target} (X_t \vert z), \quad X_0 \sim p_{\text{init}}\]对于高斯概率路径,可以证明其条件向量场具有如下解析形式:
\[u_t^\text{target} (x \vert z) = \bigg( \dot{\alpha_t} - \frac{\dot{\beta_t}}{\beta_t} \alpha_t \bigg) z + \frac{\dot{\beta_t}}{\beta_t} x\]下面给出上述公式的证明。首先构造条件流模型(conditional flow model)
\[\psi_t^{\text{target}} (x \vert z) = \alpha_t z + \beta_t x\]设\(X_t\)为上述条件流模型对应的轨迹,由高斯概率路径的定义有
\[X_t = \psi_t^{\text{target}} (X_0 \vert z) = \alpha_t z + \beta_t X_0 \sim \mathcal{N} (\alpha_t z, \beta_t^2 I_d) = p_t (\cdot \vert z)\]上式说明,我们所构造的条件流模型\(\psi_t^{\text{target}} (x \vert z)\)恰好对应高斯条件概率路径\(p_t (\cdot \vert z)\)。
接下来开始求条件向量场的具体形式。根据流模型的ODE定义\(\frac{\mathrm{d}}{\mathrm{d} t} \psi_t = u_t (\psi_t)\),可以得到
\[\begin{aligned} \frac{\mathrm{d}}{\mathrm{d} t} \psi_t^{\text{target}} (x \vert z) &= u_t^{\text{target}} (\psi_t^{\text{target}} (x \vert z) \vert z) \\ \dot{\alpha_t} z + \dot{\beta_t} x &= u_t^{\text{target}} (\alpha_t z + \beta_t x \vert z) \end{aligned}\]记\(x' = \alpha_t z + \beta_t x\),即\(x = (x' - \alpha_t z) / \beta_t\),将其代入上式则有
\[\begin{aligned} \dot{\alpha_t} z + \dot{\beta_t} \bigg( \frac{x' - \alpha_t z}{\beta_t} \bigg) &= u_t^{\text{target}} (x' \vert z) \\ \bigg( \dot{\alpha_t} - \frac{\dot{\beta_t}}{\beta_t} \alpha_t \bigg) z + \frac{\dot{\beta_t}}{\beta_t} x' &= u_t^{\text{target}} (x' \vert z) \end{aligned}\]最后将\(x'\)重新记作\(x\),就得到了高斯概率路径的条件向量场公式。
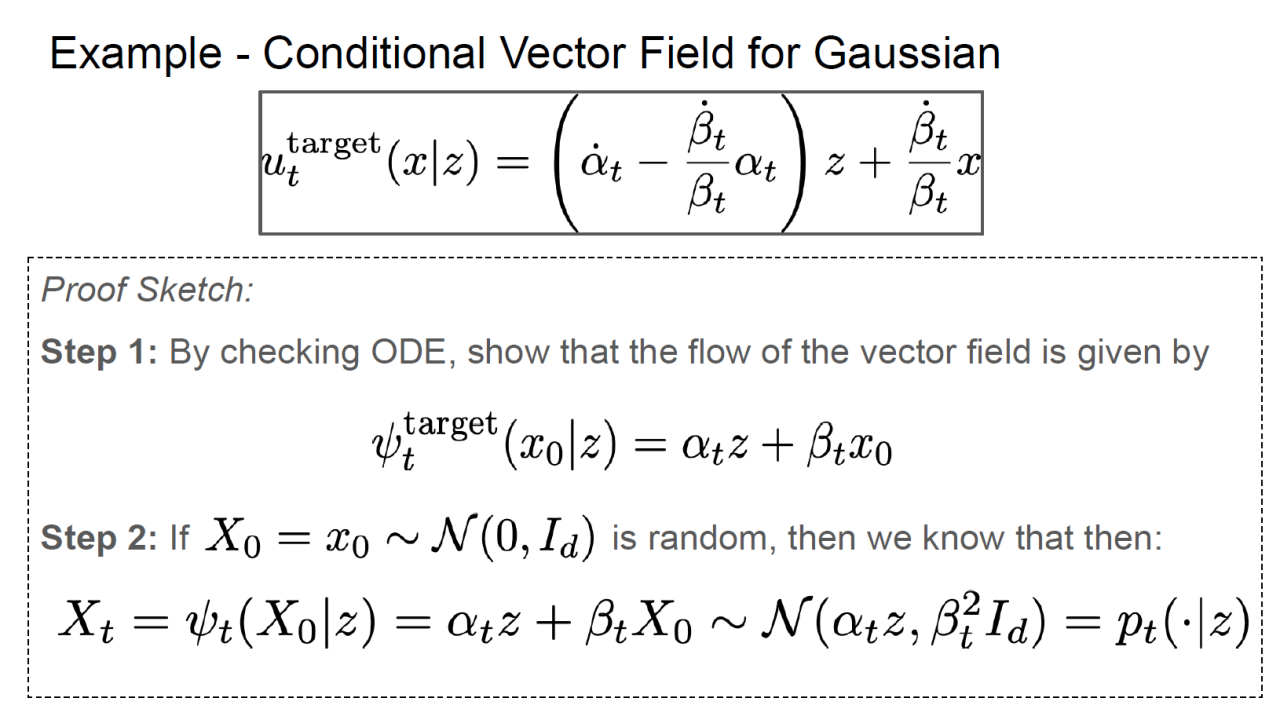
实际上,只需按照上式中的向量场进行积分,就可以将初始正态分布的噪声变换到给定的样本数据\(z\)上。
Marginal Vector Field
类似于边缘概率路径,边缘向量场(marginal vector field) \(u_t^\text{target} (x)\)描述了从初始分布\(p_{\text{init}}\)到整个数据分布\(p_{\text{data}}\)的变换过程。基于条件向量场计算边缘向量场的过程称为边缘化技巧(marginalization trick),其公式可以表达为:
\[u_t^\text{target} (x) = \int \underbrace{u_t^\text{target} (x \vert z) \vphantom{\frac{p_t(x \vert z) \ p_{\text{data}} (z)}{p_t (x)}}}_{\text{conditional vector field}} \ \underbrace{\frac{p_t(x \vert z) \ p_{\text{data}} (z)}{p_t (x)}}_{\text{posterior}} \mathrm{d} z\]其中第一项\(u_t^\text{target} (x \vert z)\)是条件向量场,而第二项\(\frac{p_t(x \vert z) \ p_{\text{data}} (z)}{p_t (x)} = p_t(z \vert x)\)则是后验分布,它表示在\(t\)时刻给定样本\(x\)时,该样本来自真实数据\(z\)的条件概率。
边缘化技巧的几何意义在于,\(t\)时刻的边缘向量场实际上是条件向量场的加权平均(条件期望),其权重为当前样本\(x\)来自不同数据\(z\)的后验分布。
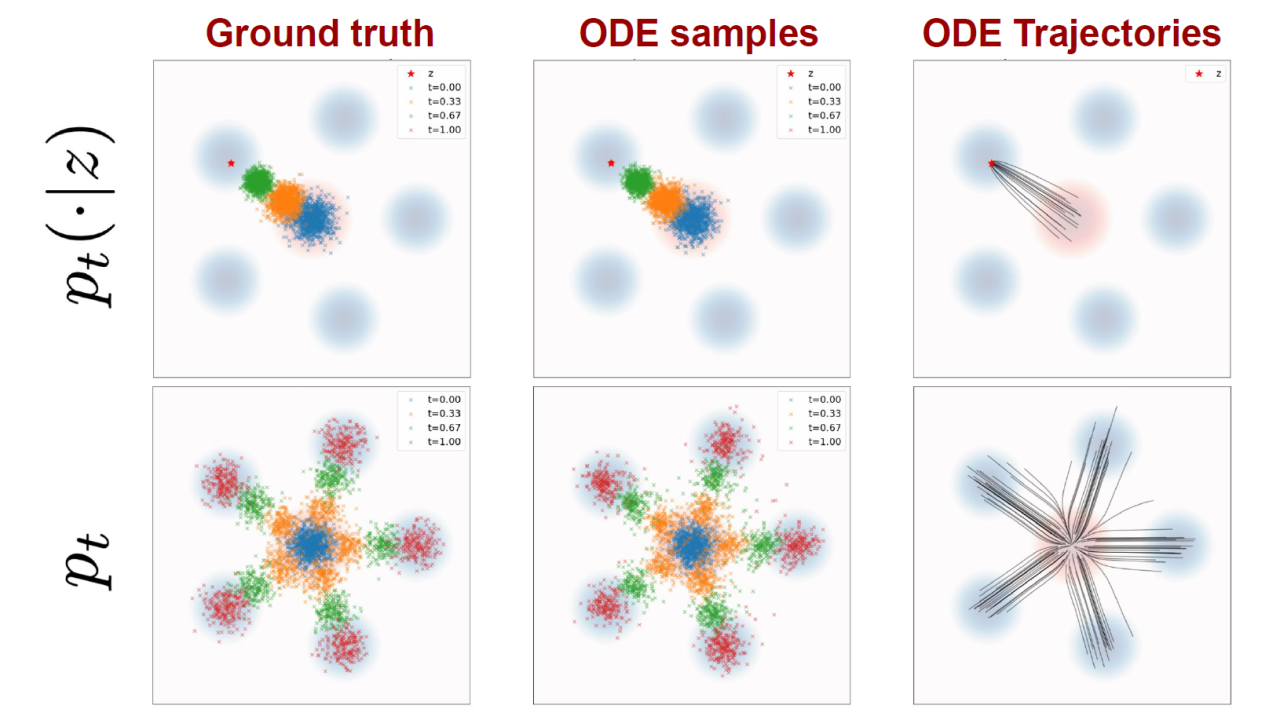
利用边缘向量场,我们就可以将初始分布\(p_{\text{init}}\)变换到数据分布\(p_{\text{data}}\)上,对应的ODE为
\[\frac{\mathrm{d}}{\mathrm{d} t} X_t = u_t^\text{target} (X_t), \quad X_0 \sim p_{\text{init}}\]条件向量场和边缘向量场的关系可以参考下图:
Continuity Equation
边缘化技巧的数学证明依赖于概率密度的连续性方程(continuity equation),它描述了概率密度函数在连续时间上的守恒关系。
\[\partial_t p_t(x) = -\nabla \cdot (p_t u_t^\text{target}) (x)\]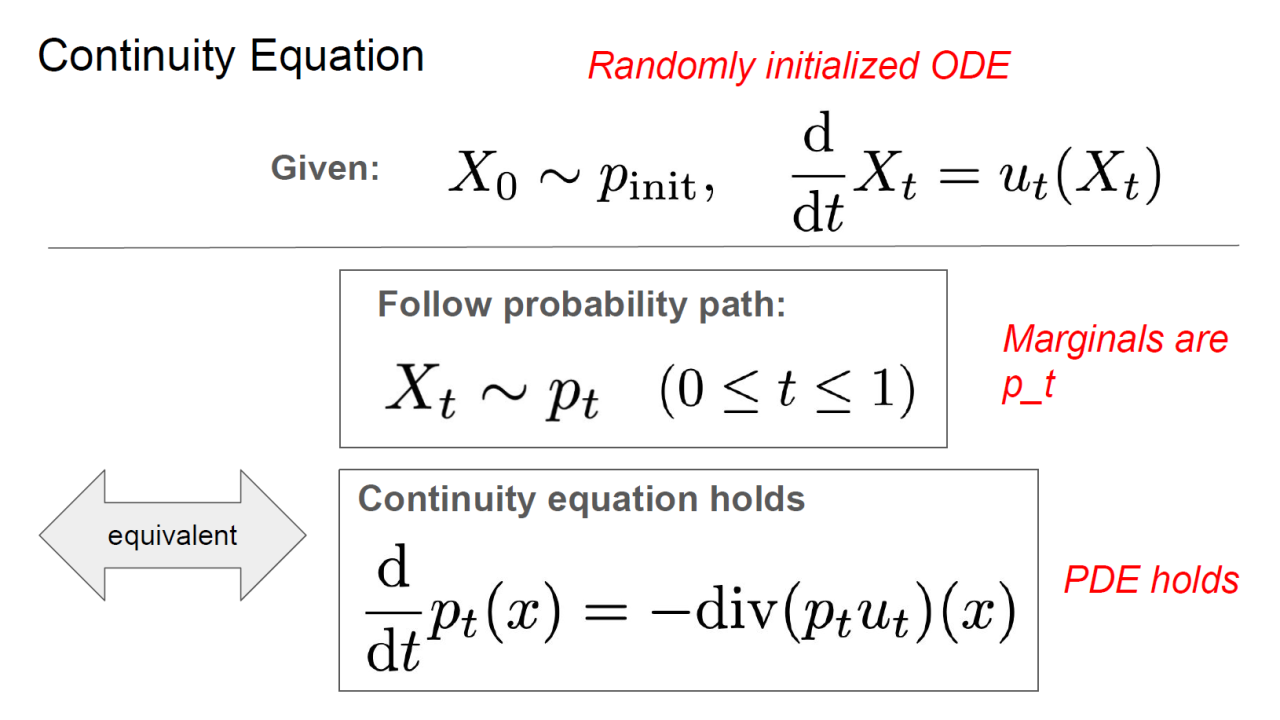
不难发现,概率密度的连续性方程实际上也是流体力学中的质量守恒方程,其物理意义在于概率质量在流动过程中既不会凭空产生也不会凭空消失:某一点上概率密度的变化率,恰好等于流入与流出该点的概率流之差。
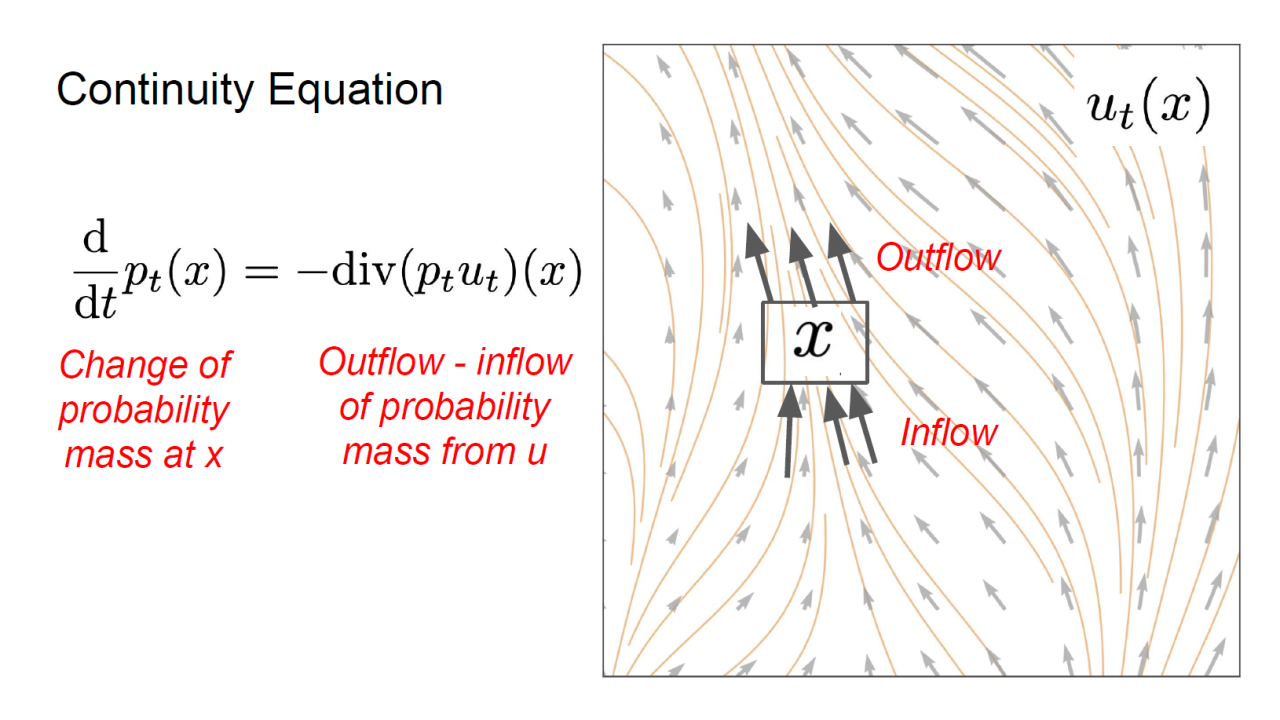
接下来我们利用连续性方程来推导边缘向量场的计算公式。对连续性方程的左端,利用边缘概率路径的定义有
\[\partial_t p_t(x) = \partial_t \int p_t (x \vert z) \ p_{\text{data}} (z) \ \mathrm{d} z = \int \partial_t p_t (x \vert z) \ p_{\text{data}} (z) \ \mathrm{d} z\]对条件概率路径\(p_t (x \vert z)\)继续使用连续性方程有
\[\partial_t p_t (x \vert z) = -\nabla \cdot (p_t (x \vert z) \ u_t^\text{target} (x \vert z))\]将其代入并整理,得到
\[\begin{aligned} \partial_t p_t(x) &= \int \partial_t p_t (x \vert z) \ p_{\text{data}} (z) \ \mathrm{d} z \\ &= \int \bigg( -\nabla \cdot (p_t (x \vert z) \ u_t^\text{target} (x \vert z)) \bigg) \ p_{\text{data}} (z) \ \mathrm{d} z \\ &= -\nabla \cdot \bigg( \int p_t (x \vert z) \ u_t^\text{target} (x \vert z) \ p_{\text{data}} (z) \ \mathrm{d} z \bigg) \\ &= -\nabla \cdot \bigg( \int u_t^\text{target} (x \vert z) \ p_t (x) \frac{p_t (x \vert z) \ p_{\text{data}} (z)}{p_t (x)} \ \mathrm{d} z \bigg) \\ &= -\nabla \cdot \bigg( p_t (x) \int u_t^\text{target} (x \vert z) \ \frac{p_t (x \vert z) \ p_{\text{data}} (z)}{p_t (x)} \ \mathrm{d} z \bigg) \end{aligned}\]再结合\(p_t (x)\)连续性方程的右端\(\partial_t p_t(x) = -\nabla \cdot (p_t u_t^\text{target}) (x)\),我们就得到了边缘向量场的计算公式:
\[u_t^\text{target} (x) = \int u_t^\text{target} (x \vert z) \ \frac{p_t (x \vert z) \ p_{\text{data}} (z)}{p_t (x)} \ \mathrm{d} z\]上式即为边缘向量场与条件向量场的计算关系式。
总结一下,概率路径和向量场的关系如下图所示:
Learning the Marginal Vector Field
最后我们来介绍如何学习边缘向量场,这实际上也是整个flow matching算法的核心所在。从直觉上看,向量场的学习过程等价于一个回归问题:对于神经网络表示的向量场\(u_t^\theta\),我们可以通过最小化它与目标向量场之间的平方误差来进行学习。因此可以构造出如下损失函数:
\[\begin{aligned} \mathcal{L}_{\text{FM}} (\theta) &= \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\theta (x) - u_t^\text{target} (x) \|^2 \big] \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[\| u_t^\theta (x) - u_t^\text{target} (x) \|^2 \big] \end{aligned}\]其中\(\text{Unif}\)表示\([0, 1]\)区间上的均匀分布。
需要注意的是,上述损失函数的拟合目标是边缘向量场\(u_t^\text{target} (x)\),而计算边缘向量场的过程比较困难,它需要对所有真实数据进行积分。然而条件向量场\(u_t^\text{target} (x \vert z)\)是容易计算的,用它替换掉边缘向量场可以得到一个更容易优化的损失函数:
\[\mathcal{L}_{\text{CFM}} (\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[\| u_t^\theta (x) - u_t^\text{target} (x \vert z) \|^2 \big]\]更进一步,flow matching算法的一大贡献在于,它从理论上证明了上述两个损失函数之间只相差一个常数
\[\mathcal{L}_{\text{FM}} (\theta) = \mathcal{L}_{\text{CFM}} (\theta) + C\]这里我们对上述结论进行证明。首先将\(\mathcal{L}_{\text{FM}}\)展开
\[\begin{aligned} \mathcal{L}_{\text{FM}} (\theta) &= \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\theta (x) - u_t^\text{target} (x) \|^2 \big] \\ &= \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\theta (x) \|^2 - 2 u_t^\theta (x)^T u_t^\text{target} (x) + \| u_t^\text{target} (x) \|^2 \big] \\ &= \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\theta (x) \|^2 \big] - 2 \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[ u_t^\theta (x)^T u_t^\text{target} (x) \big] + \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\text{target} (x) \|^2 \big] \end{aligned}\]显然上式中第三项\(\mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\text{target} (x) \|^2 \big]\)与参数\(\theta\)无关,可以将其记为\(C_1\)。因此有
\[\mathcal{L}_{\text{FM}} (\theta) = \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\theta (x) \|^2 \big] - 2 \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[ u_t^\theta (x)^T u_t^\text{target} (x) \big] + C_1\]接下来考虑第二项\(\mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[ u_t^\theta (x)^T u_t^\text{target} (x) \big]\),利用边缘向量场的计算公式,可以得到
\[\begin{aligned} \mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[ u_t^\theta (x)^T u_t^\text{target} (x) \big] &= \int_0^1 \int p_t (x) \ u_t^\theta (x)^T u_t^\text{target} (x) \ \mathrm{d} x \ \mathrm{d} t \\ &= \int_0^1 \int p_t (x) \ u_t^\theta (x)^T \int u_t^\text{target} (x \vert z) \frac{p_t(x \vert z) p_\text{data}(z)}{p_t (x)} \ \mathrm{d} z \ \mathrm{d} x \ \mathrm{d} t \\ &= \int_0^1 \int \int u_t^\theta (x)^T u_t^\text{target} (x \vert z) \ p_t(x \vert z) \ p_\text{data}(z) \ \mathrm{d} z \ \mathrm{d} x \ \mathrm{d} t \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ u_t^\theta (x)^T u_t^\text{target} (x \vert z) \big] \end{aligned}\]将上式代入\(\mathcal{L}_\text{FM}\)。注意第一项也可以改写成对\((z, x)\)联合分布的期望:由边缘化关系\(\int p_t (x \vert z) \ p_\text{data} (z) \ \mathrm{d} z = p_t (x)\),有
\[\mathbb{E}_{t \sim \text{Unif}, x \sim p_t} \big[\| u_t^\theta (x) \|^2 \big] = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[\| u_t^\theta (x) \|^2 \big]\]这样两项就具有相同的测度,可以合并到同一个期望中,配方后得到
\[\begin{aligned} \mathcal{L}_{\text{FM}} (\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[\| u_t^\theta (x) \|^2 \big] - 2 \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ u_t^\theta (x)^T u_t^\text{target} (x \vert z) \big] + C_1 \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ \| u_t^\theta (x) \|^2 - 2 u_t^\theta (x)^T u_t^\text{target} (x \vert z) + \| u_t^\text{target} (x \vert z) \|^2 - \| u_t^\text{target} (x \vert z) \|^2 \big] + C_1 \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ \| u_t^\theta (x) - u_t^\text{target} (x \vert z) \|^2 \big] + \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ -\| u_t^\text{target} (x \vert z) \|^2 \big]+ C_1 \\ &= \mathcal{L}_{\text{CFM}} (\theta) + \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ -\| u_t^\text{target} (x \vert z) \|^2 \big]+ C_1 \end{aligned}\]显然第二项\(\mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t (\cdot \vert z)} \big[ -\| u_t^\text{target} (x \vert z) \|^2 \big]\)与参数\(\theta\)无关,将它与\(C_1\)合并为常数\(C\)即可得到\(\mathcal{L}_\text{FM}\)与\(\mathcal{L}_\text{CFM}\)的关系式:
\[\mathcal{L}_{\text{FM}} (\theta) = \mathcal{L}_{\text{CFM}} (\theta) + C\]因此,无论使用哪个损失函数,它们的梯度都是相同的,也就是说我们可以通过最小化条件向量场的平方误差来学习边缘向量场。这样我们就得到了flow matching的整体算法框架:
\begin{algorithm}
\caption{Flow Matching Training Procedure (General)}
\begin{algorithmic}
\REQUIRE A dataset of samples $z \sim p_{\text{data}}$, neural network $u_t^\theta$
\FOR{each mini-batch of data}
    \STATE Sample a data example $z$ from the dataset
    \STATE Sample a random time $t \sim \text{Unif}_{[0,1]}$
    \STATE Sample $x \sim p_t(\cdot \vert z)$
    \STATE Compute loss $\mathcal{L}(\theta) = \| u_t^\theta (x) - u_t^\text{target} (x \vert z) \|^2$
    \STATE Update the model parameters $\theta$ via gradient descent on $\mathcal{L}(\theta)$
\ENDFOR
\end{algorithmic}
\end{algorithm}
Flow Matching for Gaussian Conditional Probability Paths
对于高斯概率路径,我们可以进一步简化上述算法框架。首先,高斯概率路径的条件向量场表达式为
\[u_t^\text{target} (x \vert z) = \bigg( \dot{\alpha_t} - \frac{\dot{\beta_t}}{\beta_t} \alpha_t \bigg) z + \frac{\dot{\beta_t}}{\beta_t} x\]而在\(t\)时刻采样的过程可以表示为
\[x = \alpha_t z + \beta_t \epsilon, \quad \epsilon \sim \mathcal{N} (0, I_d)\]因此,\(t\)时刻的条件向量场可以表示为
\[u_t^\text{target} (x \vert z) = \dot{\alpha_t} z + \dot{\beta_t} \epsilon\]将上述两式代入条件向量场的损失函数中,可以得到
\[\begin{aligned} \mathcal{L}_{\text{CFM}} (\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N} (0, I_d)} \big[\| u_t^\theta (x) - u_t^\text{target} (x \vert z) \|^2 \big] \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N} (0, I_d)} \big[\| u_t^\theta (\alpha_t z + \beta_t \epsilon) - (\dot{\alpha_t} z + \dot{\beta_t} \epsilon) \|^2 \big] \end{aligned}\]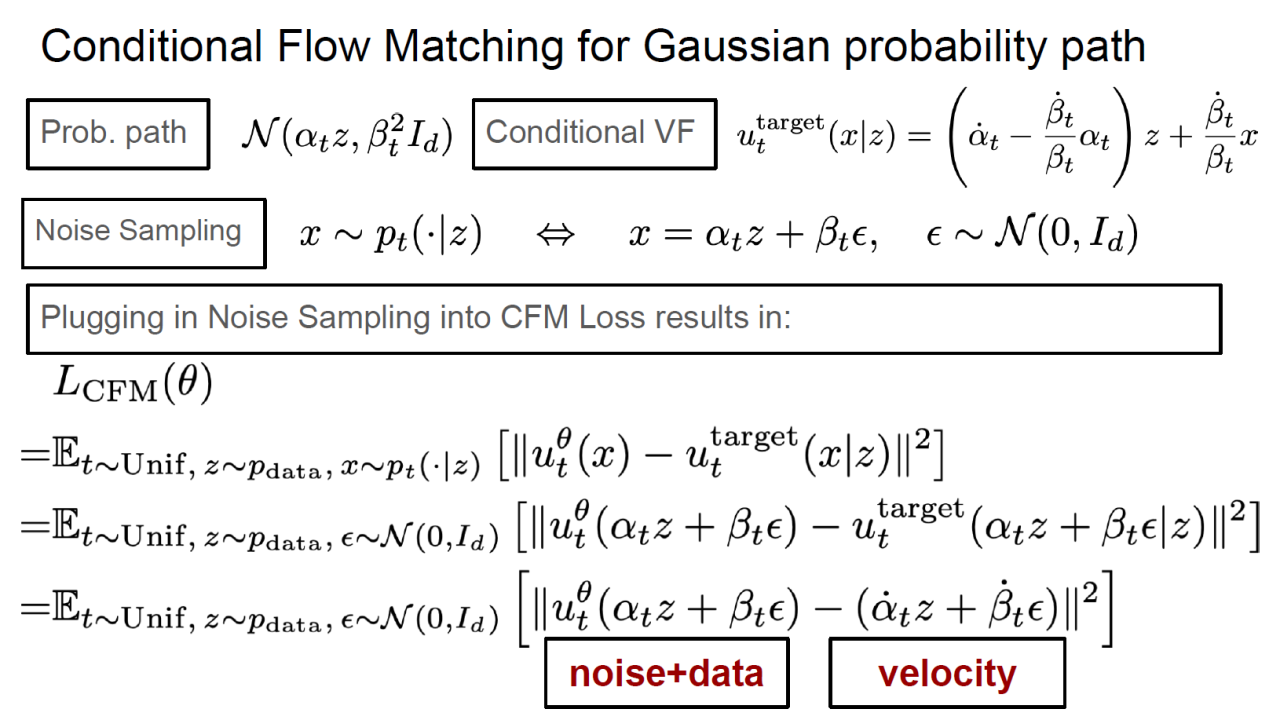
若将两个噪声调度设置为关于时间\(t\)的线性插值,则有
\[\alpha_t = t, \quad \beta_t = 1 - t\]将其代入损失函数,可以得到
\[\mathcal{L}_{\text{CFM}} (\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N} (0, I_d)} \big[\| u_t^\theta (t z + (1 - t) \epsilon) - (z - \epsilon) \|^2 \big]\]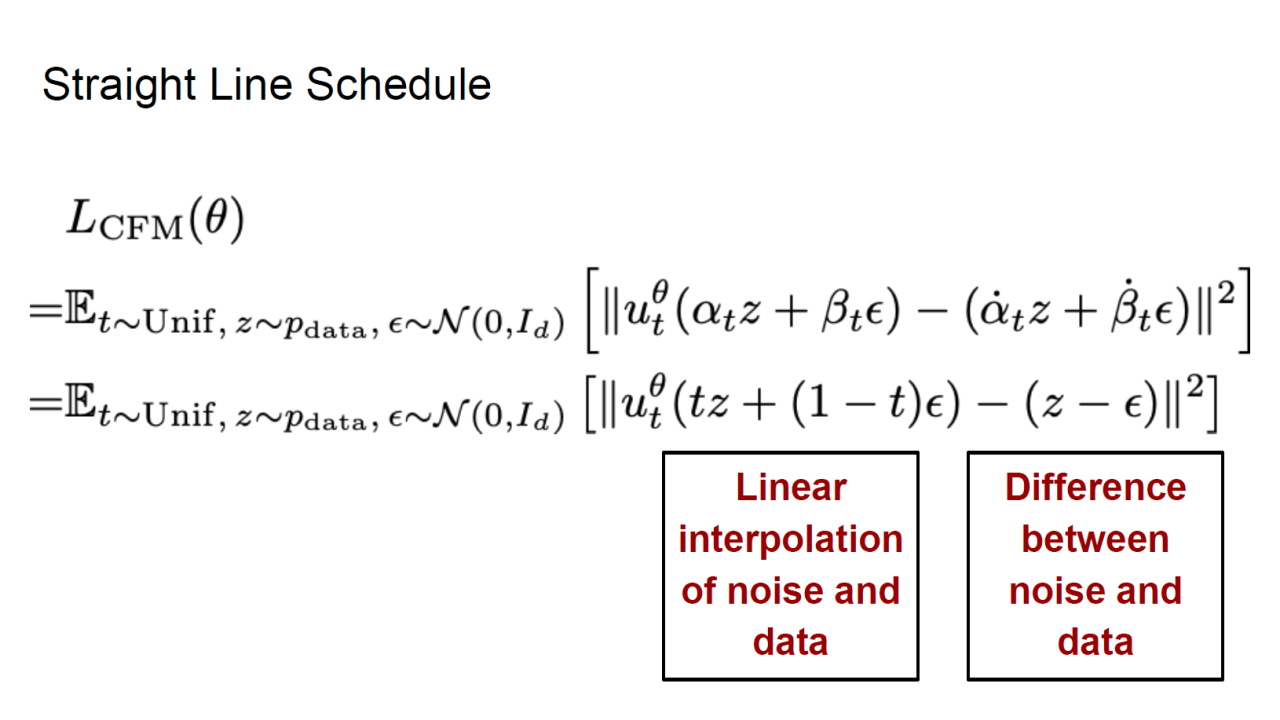
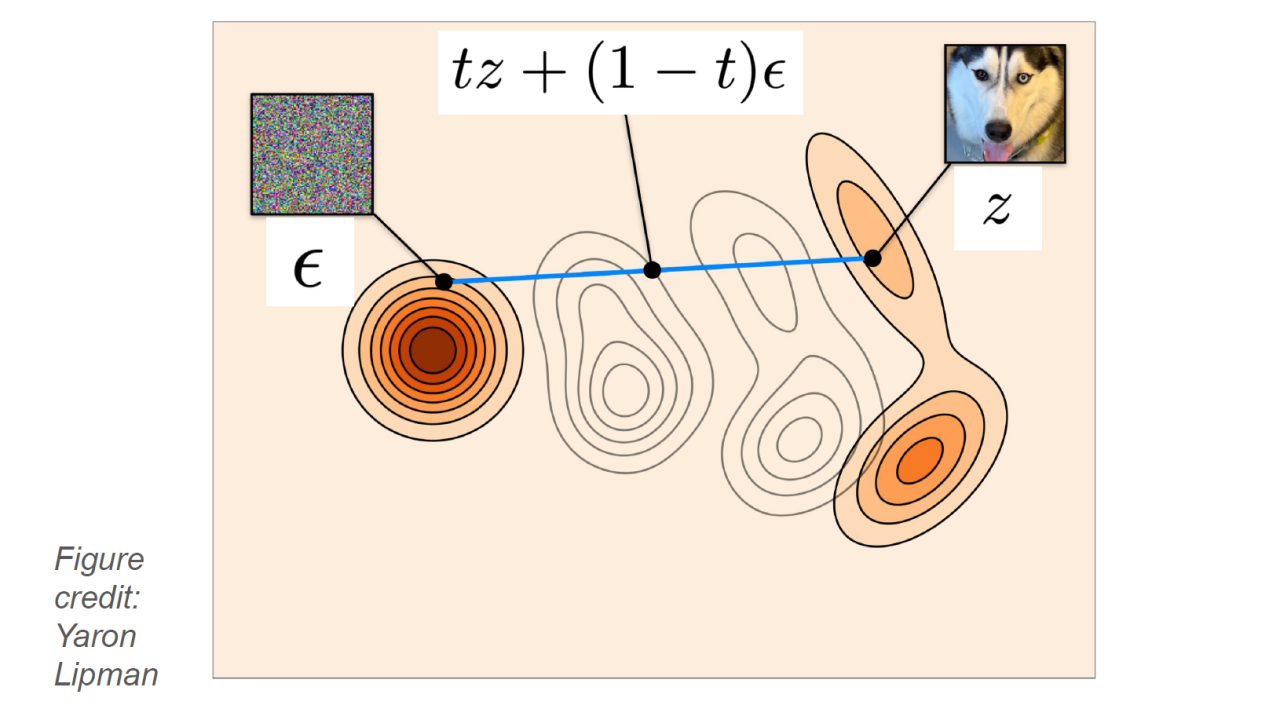
整理后可以得到高斯概率路径下的flow matching:
\begin{algorithm}
\caption{Flow Matching Training for CondOT path}
\begin{algorithmic}
\REQUIRE A dataset of samples $z \sim p_{\text{data}}$, neural network $u_t^\theta$
\FOR{each mini-batch of data}
    \STATE Sample a data example $z$ from the dataset
    \STATE Sample a random time $t \sim \text{Unif}_{[0,1]}$
    \STATE Sample noise $\epsilon \sim \mathcal{N}(0, I_d)$
    \STATE Set $x = tz + (1-t)\epsilon$
    \STATE Compute loss $\mathcal{L}(\theta) = \| u_t^\theta (x) - (z - \epsilon) \|^2$
    \STATE Update the model parameters $\theta$ via gradient descent on $\mathcal{L}(\theta)$
\ENDFOR
\end{algorithmic}
\end{algorithm}
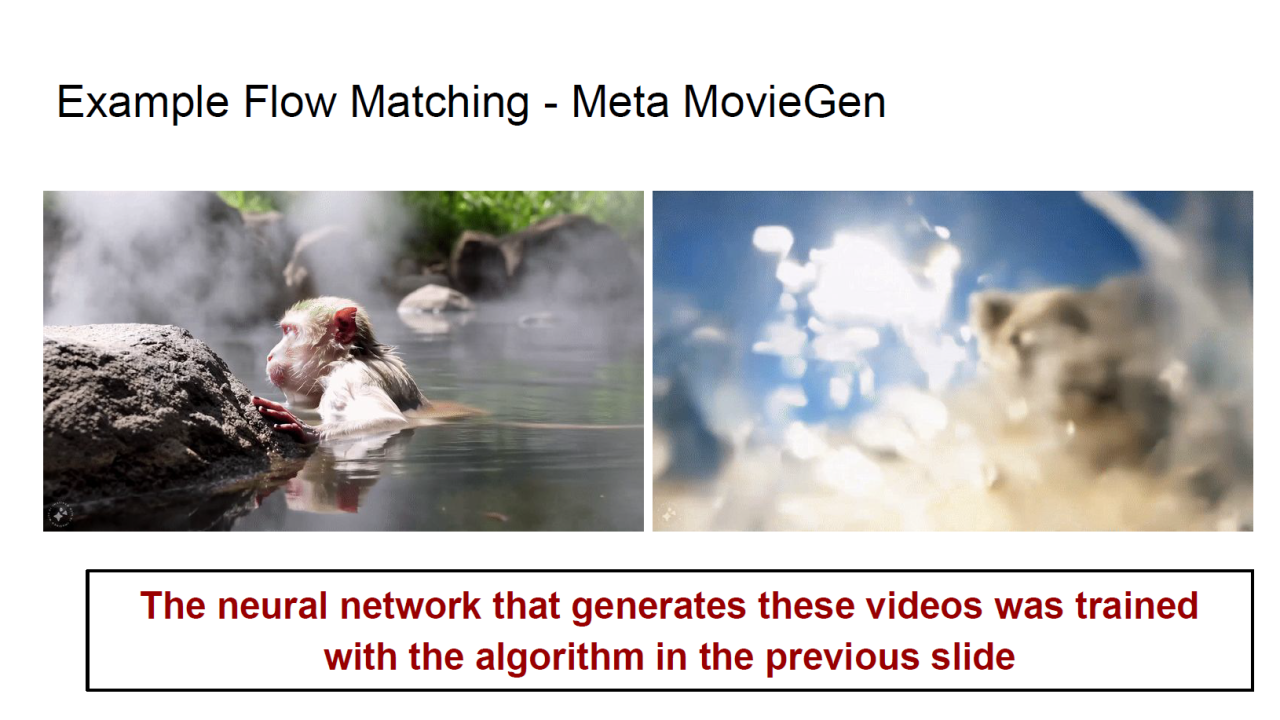
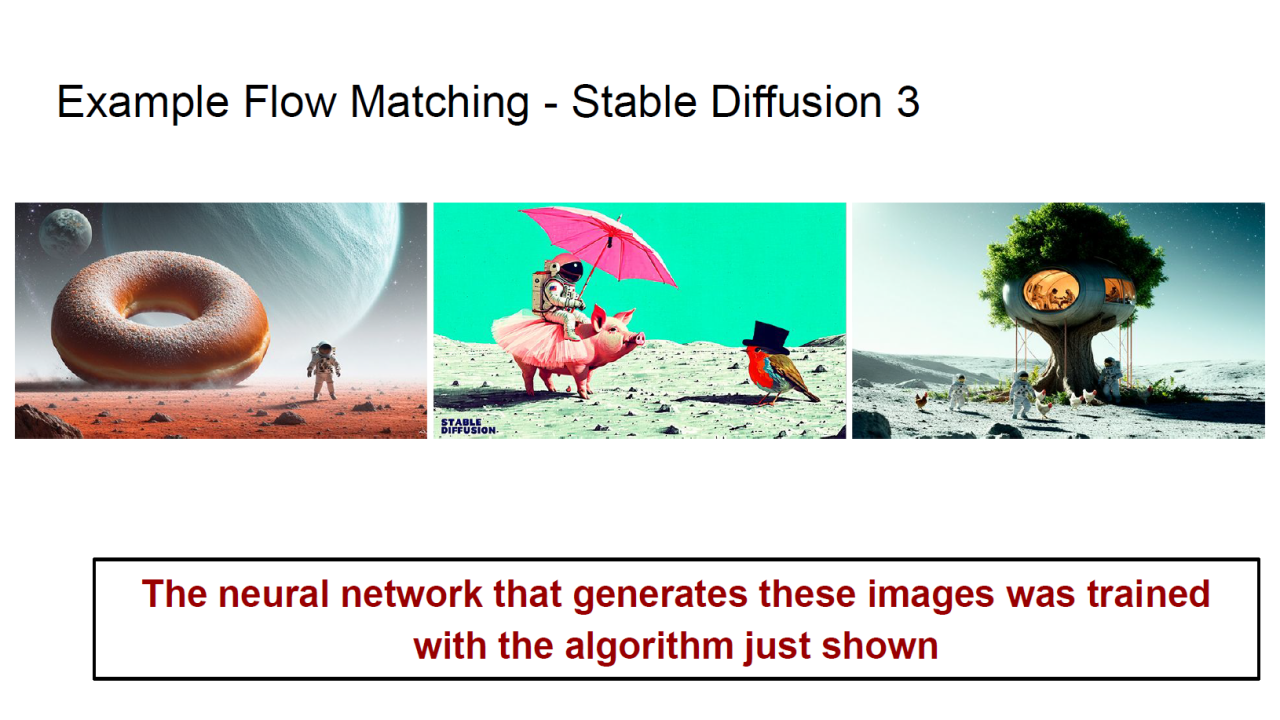
实际上,目前最先进的生成模型大多都基于上述高斯路径的flow matching算法进行训练。
本节课的主要内容可以总结如下: