MIT 6.S184课程笔记5-Latent Spaces and Neural Network Architectures
这个系列是MIT 6.S184 - Introduction to Flow Matching and Diffusion Models的同步课程笔记。本门课程面向希望深入理解流模型与扩散模型的学生和研究者,从最基础的数学工具出发,逐步推导这些模型背后的数学原理,并介绍相应的训练与采样算法。本节课主要介绍隐空间中的生成技术以及相关的网络模型架构。
Latent Space
对于现实中的生成任务,一个巨大的挑战在于数据的维度往往非常巨大。以图像生成为例,一张分辨率为600×1000的彩色图像,其维度可以达到百万级别。如此高的维度不仅让生成任务的建模变得异常困难,训练与采样时的计算和显存开销也同样难以承受。对于flow matching相关的模型,这样的问题会更加严峻:模型学习到的速度场与数据本身是同维度的,在高维空间中进行网络前向计算以及沿时间积分都会带来严重的效率问题。
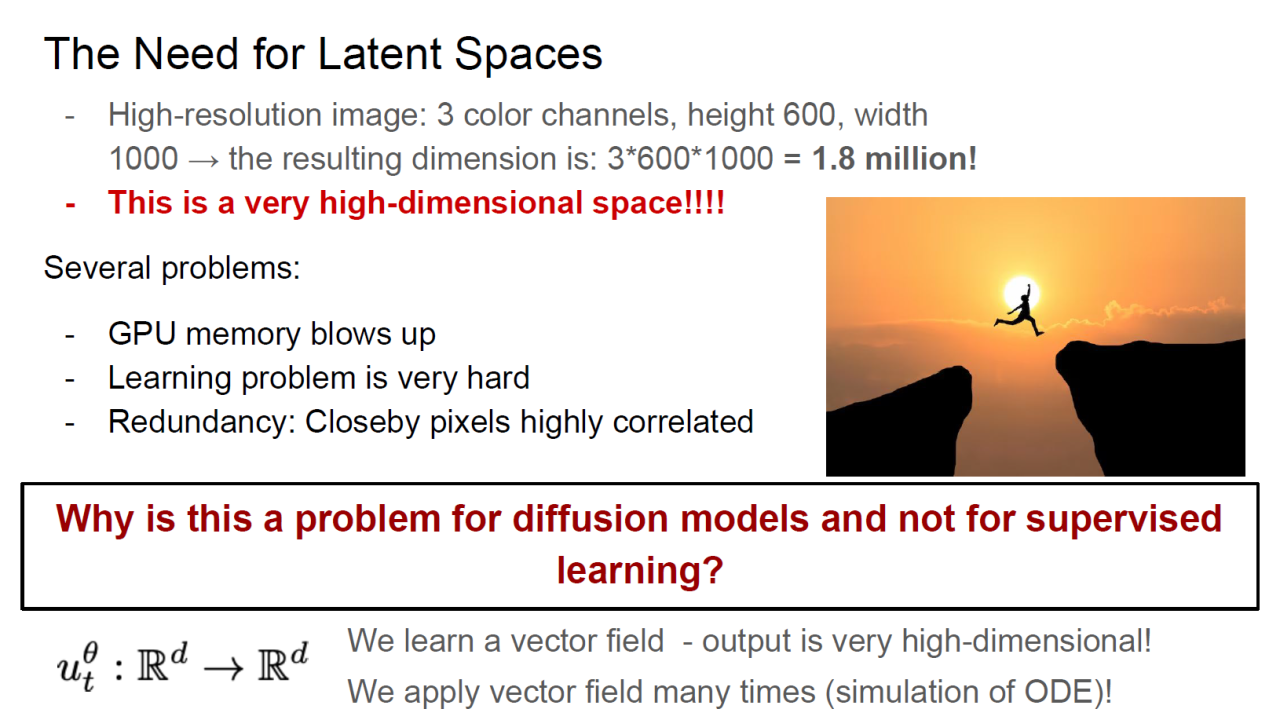
处理高维数据时的一个常用技巧是先将数据映射到低维空间,然后在低维空间中进行计算,这样的低维空间称为隐空间(latent space)。具体来说,我们可以用一个网络\(\mu_\phi\)把原始的\(d\)维数据压缩到一个维度更低的\(k\)维隐空间中,在隐空间中完成计算,再通过网络\(\mu_\theta\)把结果恢复到原始的\(d\)维空间中。这种对称的模型结构称为自编码器(autoencoder),其中负责压缩的部分称为encoder,负责还原的部分称为decoder。训练autoencoder也非常简单,只需在训练数据上最小化重建误差:
\[\mathcal{L}_\text{Recon} (\phi, \theta) = \mathbb{E}_{x \sim p_\text{data}} [ \| \mu_\theta (\mu_\phi (x))- x \|^2 ]\]
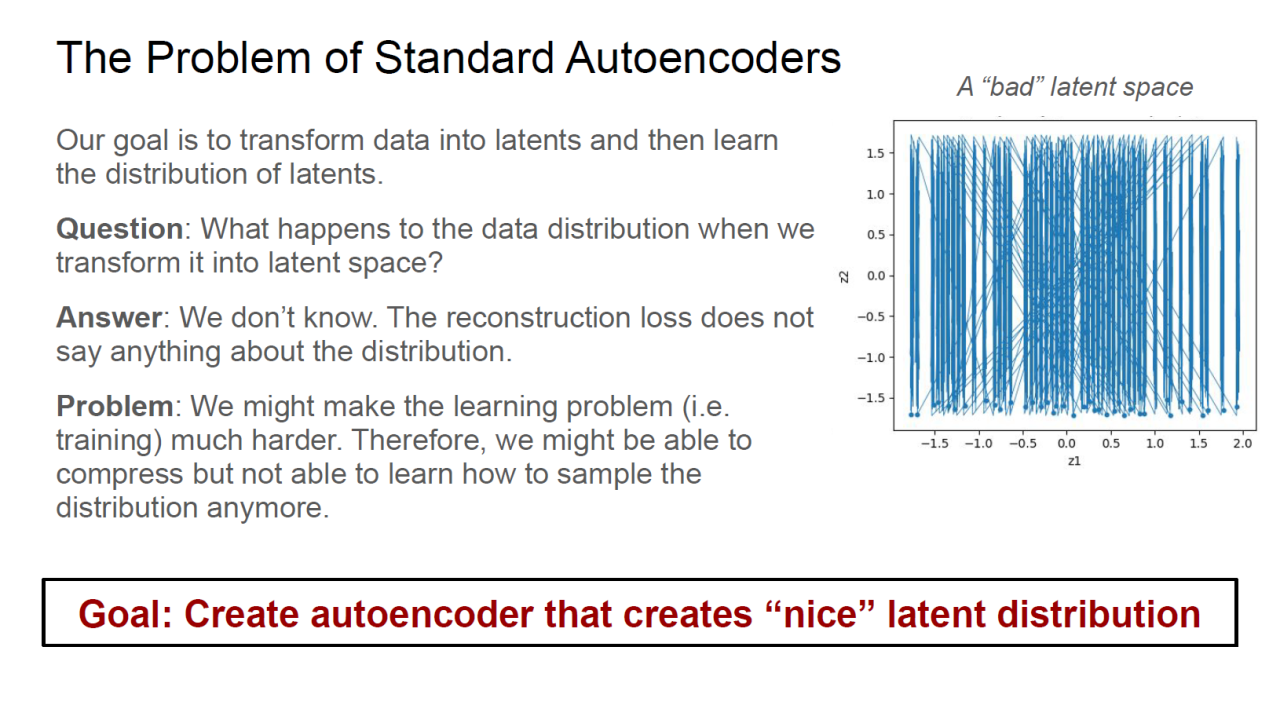
因此,将flow matching与autoencoder相结合,就可以把生成过程放到隐空间中进行,从而缓解高维数据带来的计算压力。然而遗憾的是,这样得到的生成结果往往并不理想。其中一个重要原因是,autoencoder在压缩时会把原始数据映射为隐空间中一个过于复杂的分布,而这样的分布通常并不适合直接作为flow matching的输入,反而会让原本的生成问题变得更加困难。
Variational Autoencoder
对于flow matching这样的生成任务,相比于普通的autoencoder,更好的选择是使用变分自编码器(variational autoencoder, VAE)来构造隐空间。实际上VAE本身也是一种生成模型:与autoencoder不同,VAE中的encoder和decoder不再是确定性的映射,而是对应着条件概率分布。具体来说,encoder把输入数据\(x\)映射为隐空间中的条件分布
\[q_\phi (z \vert x) = \mathcal{N} (z; \mu_\phi (x), \sigma^2_\phi (x) I_k )\]而decoder则把隐变量\(z\)映射回原始数据空间中的条件分布
\[p_\theta (x \vert z) = \mathcal{N} (x; \mu_\theta (z), \sigma^2_\theta (z) I_d )\]Training and Loss
由于VAE的encoder和decoder给出的都是概率分布,autoencoder中的重建误差在这里就不再适用了。在VAE中我们希望样本\(x\)经过编码再解码之后能够尽可能地还原出它本身,因此可以构造出重建损失:
\[\mathcal{L}_\text{VAE-Recon} (\phi, \theta) = -\mathbb{E}_{x \sim p_\text{data} (x),\, z \sim q_\phi ( \cdot \vert x)} [ \log{p_\theta (x \vert z)} ]\]对于正态分布,把上式展开可以得到
\[\mathcal{L}_\text{VAE-Recon} (\phi, \theta) = \mathbb{E}_{x \sim p_\text{data} (x),\, z \sim q_\phi (z \vert x)} \left[ \frac{1}{2 \sigma^2_\theta (z)} \| x - \mu_\theta (z) \|^2 + \frac{d}{2} \log \sigma^2_\theta (z) \right] + \text{const}\]其中第一项正对应autoencoder的重建误差;第二项来自高斯分布的归一化系数,可以理解为对decoder给出的不确定性的惩罚,大多数实现会直接忽略这一项。这样VAE的重建损失就化简为:
\[\mathcal{L}_\text{VAE-Recon} (\phi, \theta) = \mathbb{E}_{x \sim p_\text{data} (x),\, z \sim q_\phi (z \vert x)} \left[ \frac{1}{2 \sigma^2_\theta (z)} \| x - \mu_\theta (z) \|^2 \right] + \text{const}\]除了重建损失外,我们还需要对encoder给出的分布进行约束,使它在隐空间中尽可能接近某个先验分布\(p_\text{prior} (z)\)。这就需要一个能够度量两个分布之间差异的工具,其中最常用的是KL散度(Kullback-Leibler divergence):
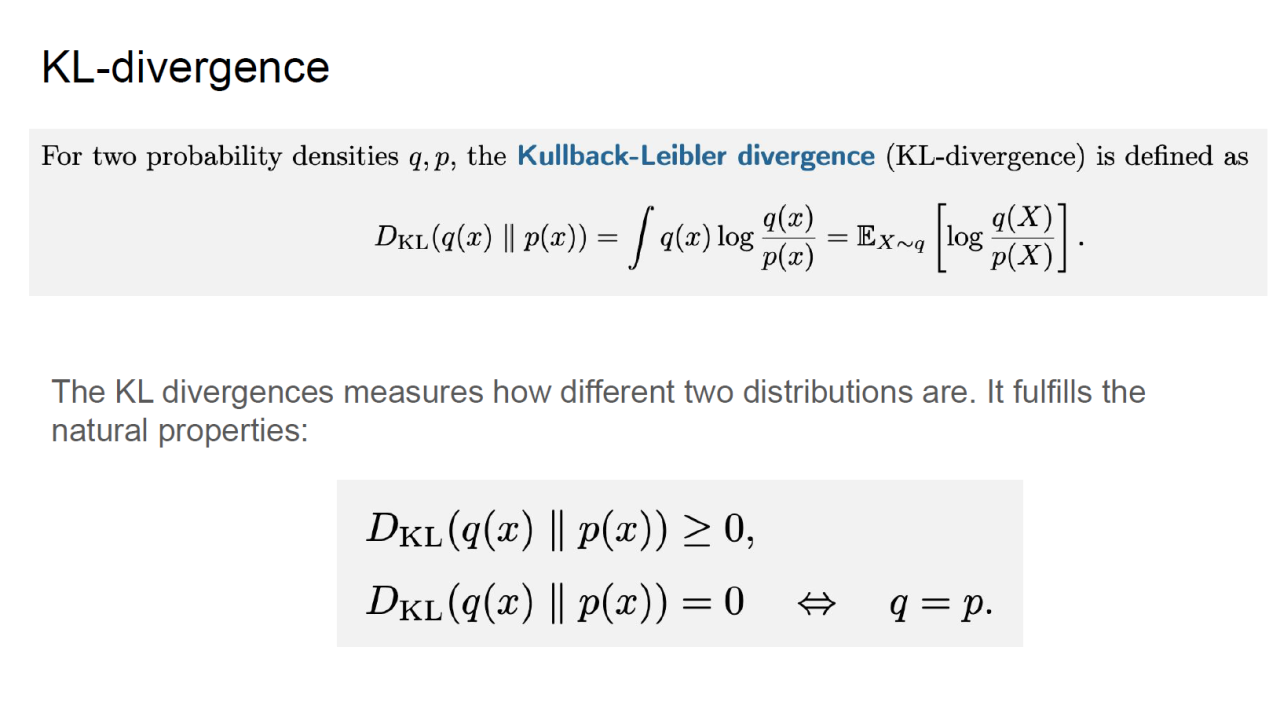
\[D_{\text{KL}} \big( q(x) \,\|\, p(x) \big) = \int q(x) \log \frac{q(x)}{p(x)} \,\mathrm{d}x = \mathbb{E}_{X \sim q} \left[ \log \frac{q(X)}{p(X)} \right]\]从某种意义上讲,KL散度可以看作两个分布之间的"距离":它满足非负性,且仅当两个分布(几乎处处)相同时取值为零。不过KL散度并不满足对称性,即一般来说\(D_{\text{KL}} (q \,\|\, p) \neq D_{\text{KL}} (p \,\|\, q)\),因此它并不是严格意义上的距离度量。
对于两个正态分布\(q(x) = \mathcal{N} (x; \mu_q, \sigma_q^2 I_d)\)和\(p(x) = \mathcal{N} (x; \mu_p, \sigma_p^2 I_d)\),KL散度具有解析形式:
\[D_{\text{KL}} \big( q(x) \,\|\, p(x) \big) = \frac{1}{2} \bigg( \mathcal{K} \bigg( \frac{\sigma_q^2}{\sigma_p^2} \bigg) + \frac{\| \mu_q - \mu_p \|^2}{\sigma_p^2} \bigg)\] \[\mathcal{K} (\alpha) = \sum_i \big( \alpha_i - \log \alpha_i - 1 \big)\]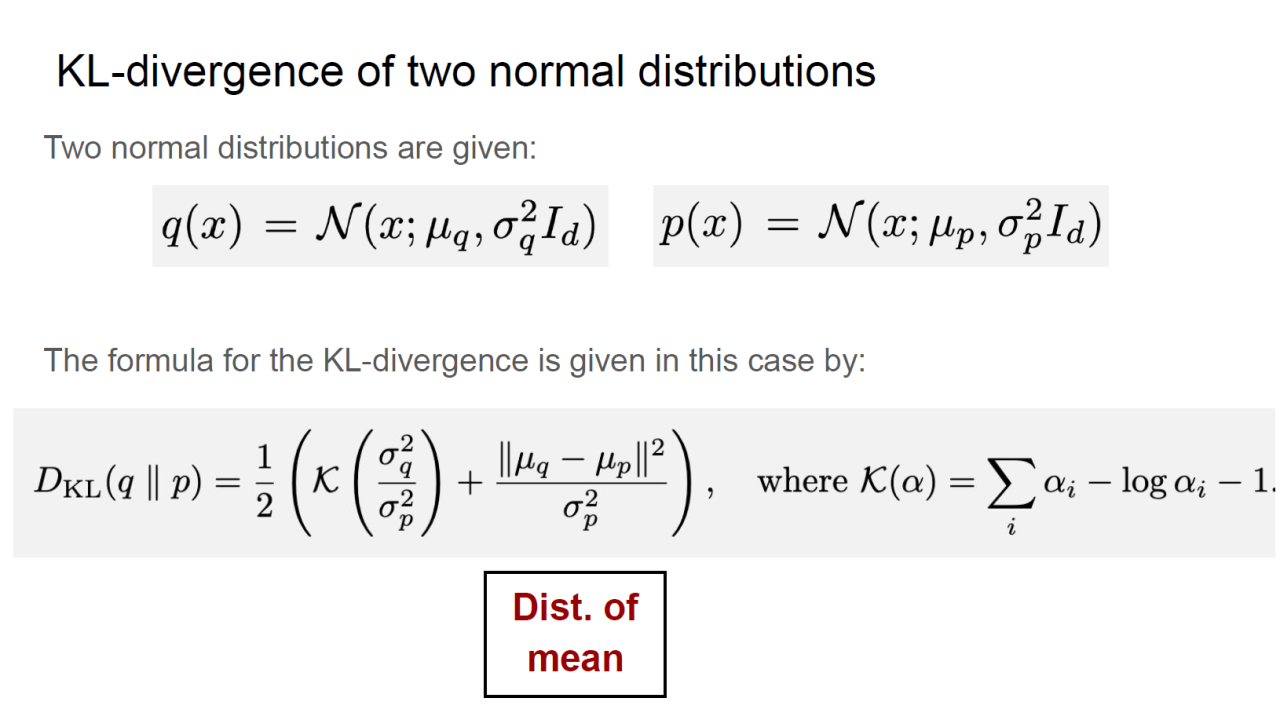
在VAE中,通常可以取先验分布\(p_\text{prior} (z)\)为标准正态分布\(\mathcal{N} (0, I_k)\),因此可以得到VAE的先验损失:
\[\begin{aligned} \mathcal{L}_\text{VAE-Prior} (\phi) &= \mathbb{E}_{x \sim p_\text{data} (x)} \big[ D_{\text{KL}} \big( q_\phi ( \cdot \vert x) \,\|\, \mathcal{N} (0, I_k) \big) \big] \\ &= \mathbb{E}_{x \sim p_\text{data} (x)} \left[ \frac{1}{2} \mathcal{K} \big( \sigma^2_\phi (x) \big) + \frac{1}{2} \| \mu_\phi (x) \|^2 \right] \end{aligned}\]将重建损失和先验损失加权结合起来,就得到VAE的总损失函数,其中\(\beta \geq 0\)是用于权衡重建质量与先验约束的超参数:
\[\begin{aligned} \mathcal{L}_\text{VAE} (\phi, \theta) &= \mathcal{L}_\text{VAE-Recon} (\phi, \theta) + \beta \, \mathcal{L}_\text{VAE-Prior} (\phi) \\ &= \mathbb{E}_{x \sim p_\text{data} (x),\, z \sim q_\phi (z \vert x)} \Bigg[ \underbrace{\frac{1}{2 \sigma^2_\theta (z)} \| x - \mu_\theta (z) \|^2}_{\text{recon. error}} + \underbrace{\frac{\beta}{2} \mathcal{K} \big( \sigma^2_\phi (x) \big)}_{\text{make latent variance} = 1} + \underbrace{\frac{\beta}{2} \| \mu_\phi (x) \|^2}_{\text{make latent mean} = 0} \Bigg] \end{aligned}\]Reparameterization Trick
得到损失函数后就可以着手训练VAE了。但这里有一个麻烦:损失函数中需要对隐变量\(z \sim q_\phi (z \vert x)\)求期望,而这个分布本身由参数\(\phi\)决定,采样操作又是不可微的,梯度无法穿过采样这一步回传到encoder。不过对于正态分布,我们可以使用重参数化技巧(reparameterization trick)来解决这个问题。回忆隐变量\(z\)服从正态分布
\[z \sim q_\phi (z \vert x) = \mathcal{N} (z; \mu_\phi (x), \sigma^2_\phi (x) I_k )\]我们可以引入一个与模型参数无关的标准正态随机变量\(\epsilon \sim \mathcal{N} (0, I_k)\),把\(z\)改写为
\[z = \mu_\phi (x) + \sigma_\phi (x) \epsilon\]这样一来,采样过程中的随机性全部转移到与\(\phi\)无关的\(\epsilon\)上,\(\mu_\phi (x)\)和\(\sigma_\phi (x)\)则成为可微的确定性函数,梯度得以顺利回传到encoder。相应地,完整的VAE损失函数可以写成
\[\mathcal{L}_\text{VAE} (\phi, \theta) = \mathbb{E}_{x \sim p_\text{data} (x),\, \epsilon \sim \mathcal{N} (0, I_k)} \left[ \frac{1}{2 \sigma^2} \big\| x - \mu_\theta \big( \mu_\phi (x) + \sigma_\phi (x) \epsilon \big) \big\|^2 + \frac{\beta}{2} \mathcal{K} \big( \sigma^2_\phi (x) \big) + \frac{\beta}{2} \| \mu_\phi (x) \|^2 \right]\]整理一下可以得到VAE的训练算法:
\begin{algorithm}
\caption{$\beta$-VAE Training Procedure (Gaussian decoder with fixed variance $p_\theta (x \vert z) = \mathcal{N} (x; \mu_\theta (z), \tilde{\sigma}^2 I_d)$)}
\begin{algorithmic}
\REQUIRE Dataset of samples $x \sim p_\text{data}$, encoder networks $(\mu_\phi (x), \log \sigma_\phi^2 (x))$, decoder network $\mu_\theta (z)$, latent dim $k$, constants $\beta \geq 0$, $\tilde{\sigma}^2 > 0$
\FOR{each mini-batch $\{x_i\}_{i=1}^B$}
    \STATE Encode each $x_i$: $\mu_i \leftarrow \mu_\phi (x_i)$, $\log \sigma_i^2 \leftarrow \log \sigma_\phi^2 (x_i)$
    \STATE Sample noise $\epsilon_i \sim \mathcal{N} (0, I_k)$
    \STATE Reparameterize: $z_i \leftarrow \mu_i + \sigma_i \odot \epsilon_i$, where $\sigma_i = \exp (\frac{1}{2} \log \sigma_i^2)$
    \STATE Decode mean: $\hat{x}_i \leftarrow \mu_\theta (z_i)$
    \STATE Reconstruction loss: $\mathcal{L}_\text{recon} \leftarrow \frac{1}{B} \sum_{i=1}^B \frac{1}{2 \tilde{\sigma}^2} \| x_i - \hat{x}_i \|^2$
    \STATE KL loss to the prior $p_\text{prior} (z) = \mathcal{N} (0, I_k)$: $\mathcal{L}_\text{KL} \leftarrow \frac{1}{B} \sum_{i=1}^B \frac{1}{2} \sum_{j=1}^k \big( \mu_{i,j}^2 + \sigma_{i,j}^2 - \log \sigma_{i,j}^2 - 1 \big)$
    \STATE Total loss: $\mathcal{L} \leftarrow \mathcal{L}_\text{recon} + \beta \mathcal{L}_\text{KL}$
    \STATE Update $(\phi, \theta) \leftarrow \text{grad\_update} (\mathcal{L})$
\ENDFOR
\end{algorithmic}
\end{algorithm}
训练好VAE之后,我们只需要让flow matching在隐空间中进行,编码和解码的过程则完全交给VAE来完成。目前主流的图像与视频生成模型大多都采用了这一范式。