MIT 6.S184课程笔记3-Score Functions and Score Matching
这个系列是MIT 6.S184 - Introduction to Flow Matching and Diffusion Models的同步课程笔记。本门课程面向希望深入理解流模型与扩散模型的学生和研究者,从最基础的数学工具出发,逐步推导这些模型背后的数学原理,并介绍相应的训练与采样算法。本节课主要介绍Score Matching算法背后的数学原理。
在上一节课中,我们从条件概率和边缘概率两个视角介绍了概率路径以及向量场的概念。
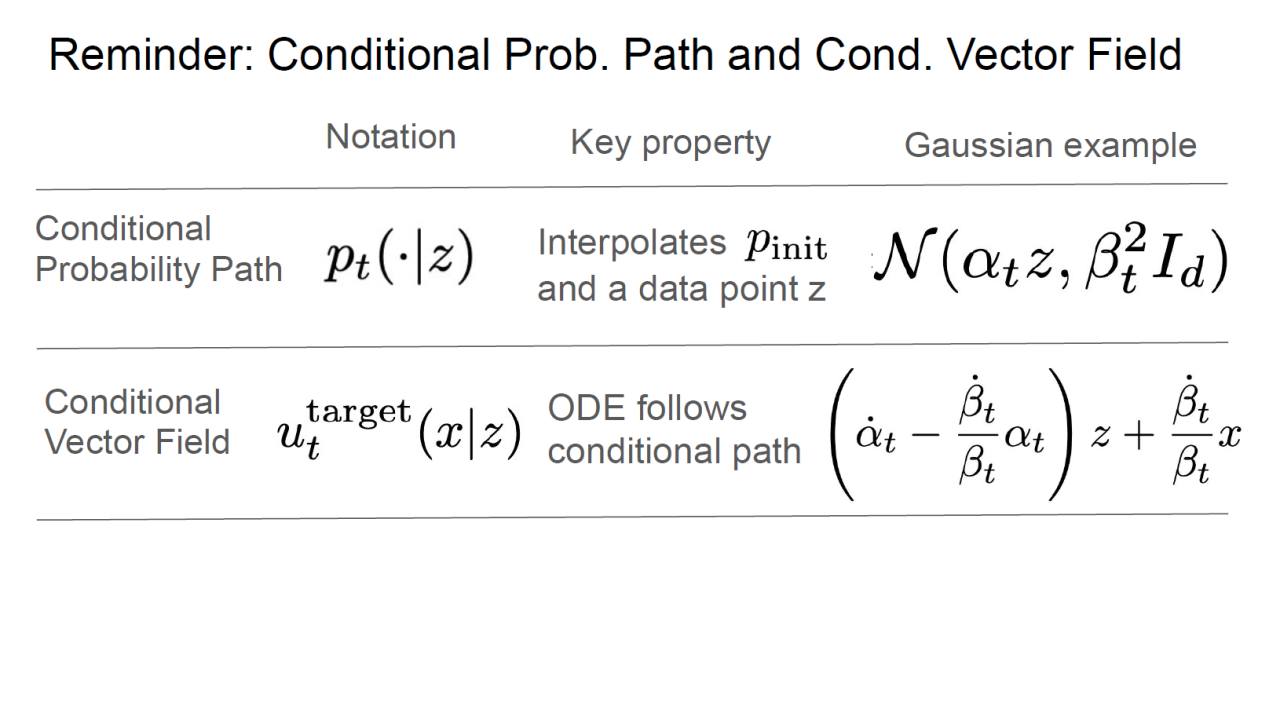
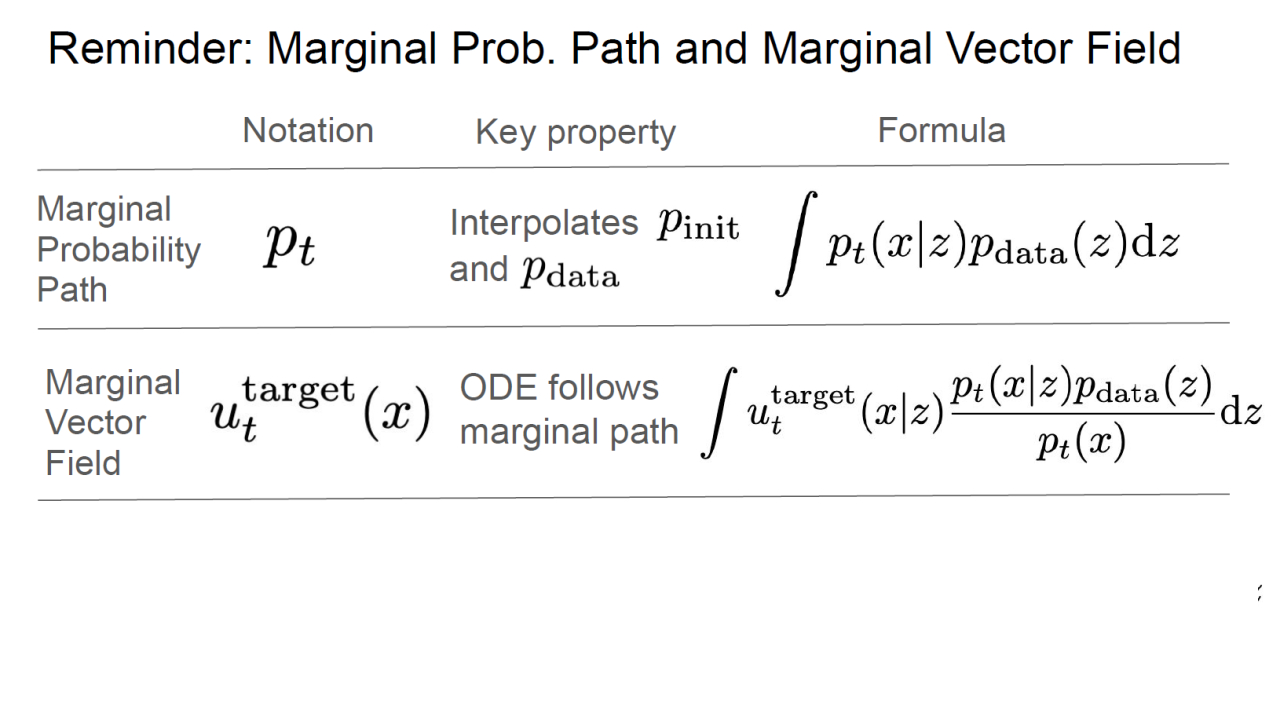
在此基础上,我们推导出了flow matching算法的损失函数以及训练过程。
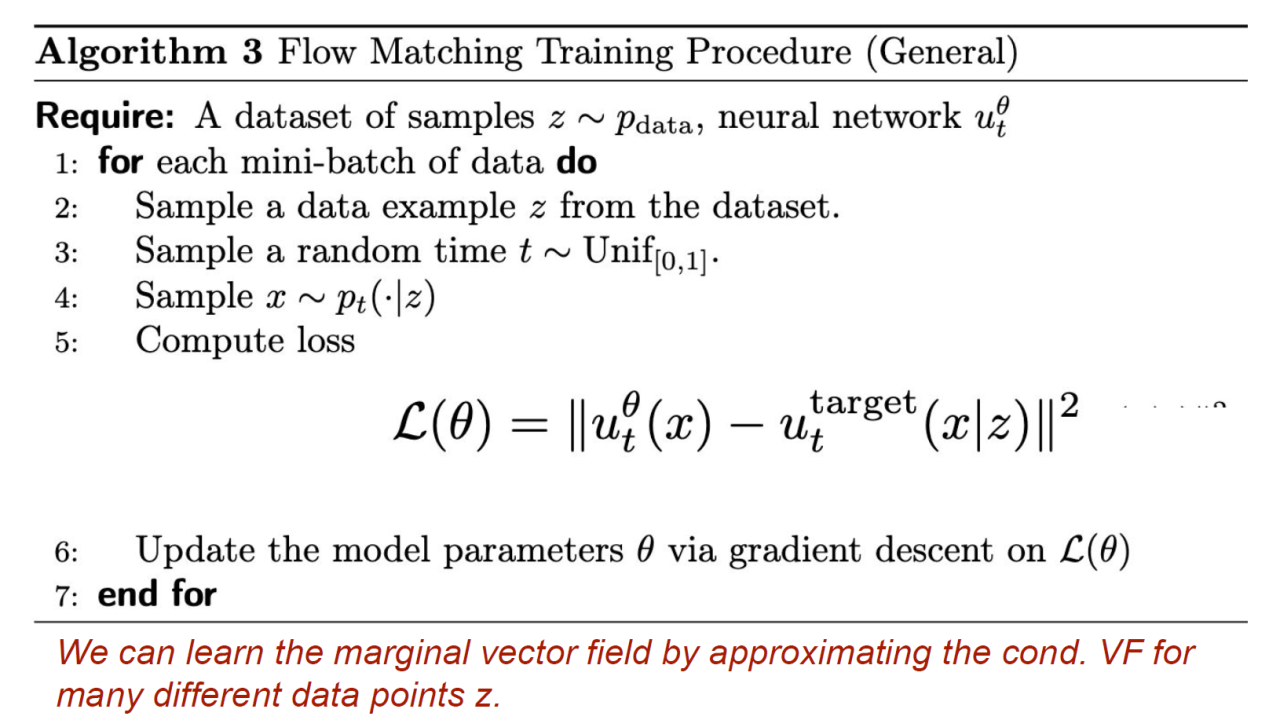
得到(边缘)向量场后,我们就可以使用ODE进行采样实现数据的生成。
本节课中,我们会引入score function的概念,并学习如何基于SDE和score function来实现生成。
Score Function
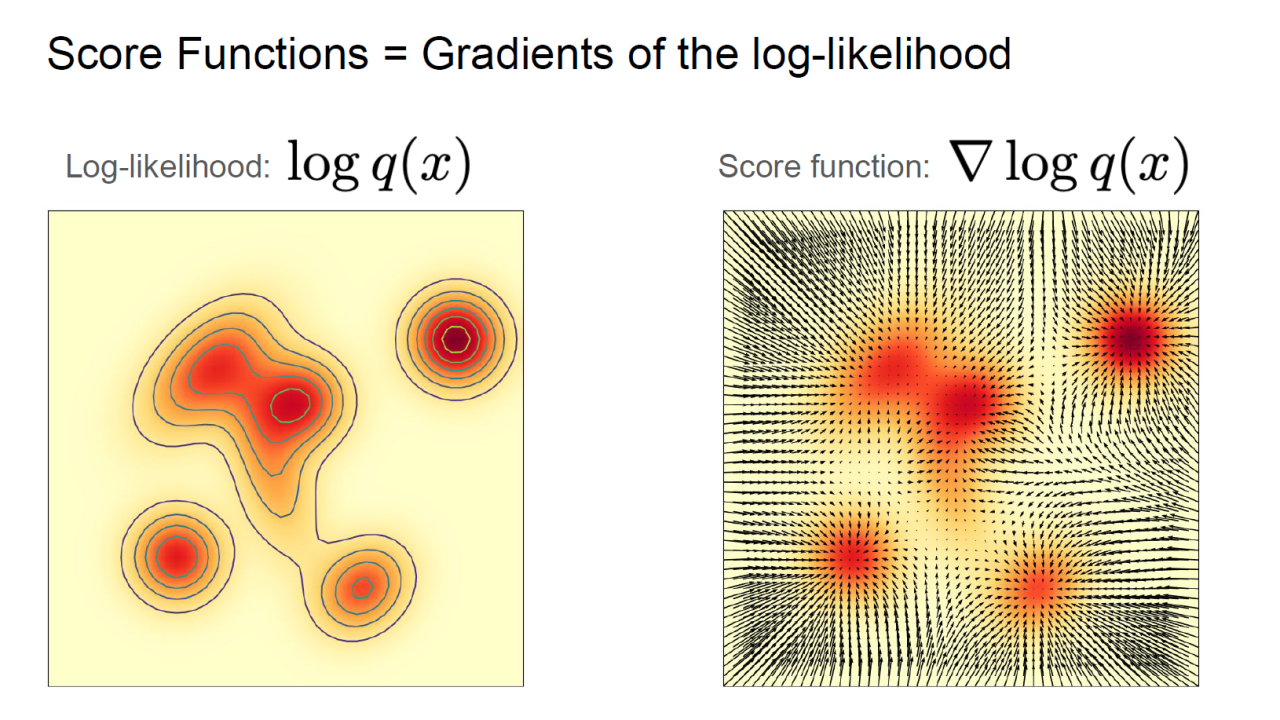
score function定义为对数似然函数\(\log q (x)\)的梯度,即\(\nabla \log q (x)\)。从优化的角度来看,score function是使对数似然函数增大最快的方向。
类似于条件概率路径和边缘概率路径,我们也可以定义conditional score function和marginal score function分别为\(\nabla \log p_t(x \vert z)\)和\(\nabla \log p_t(x)\),它们之间的关系式如下:
\[\begin{aligned} \nabla \log p_t(x) &= \frac{\nabla p_t (x)}{p_t (x)} = \frac{\nabla \int p_t (x \vert z) p_{\text{data}} (z) \mathrm{d} z}{p_t (x)} \\ &= \frac{\int \nabla p_t (x \vert z) p_{\text{data}} (z) \mathrm{d} z}{p_t (x)} \\ &= \frac{\int \nabla \log p_t (x \vert z) \ p_t (x \vert z) \ p_{\text{data}} (z) \mathrm{d} z}{p_t (x)} \\ &= \int \nabla \log p_t(x \vert z) \frac{p_t (x \vert z) p_{\text{data}} (z)}{p_t (x)} \mathrm{d} z \end{aligned}\]不难发现,上式中两个score function的关系类似于向量场的边缘化技巧:marginal score function是conditional score function关于后验\(\frac{p_t (x \vert z) p_{\text{data}} (z)}{p_t (x)}\)的期望。
Score of Gaussian Probability Path
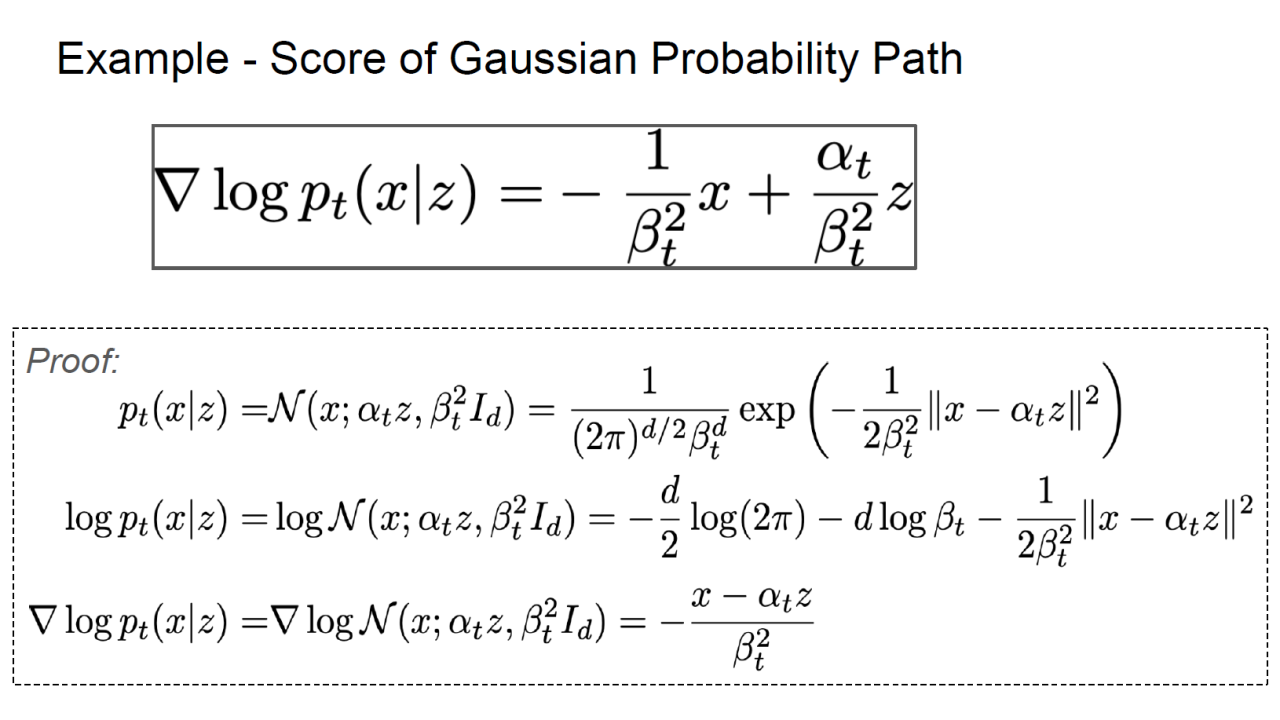
对于高斯概率路径,我们可以显式计算它的conditional score function。
类似地,我们可以计算marginal score function。整理一下可以得到高斯概率路径相关的所有计算公式如下:
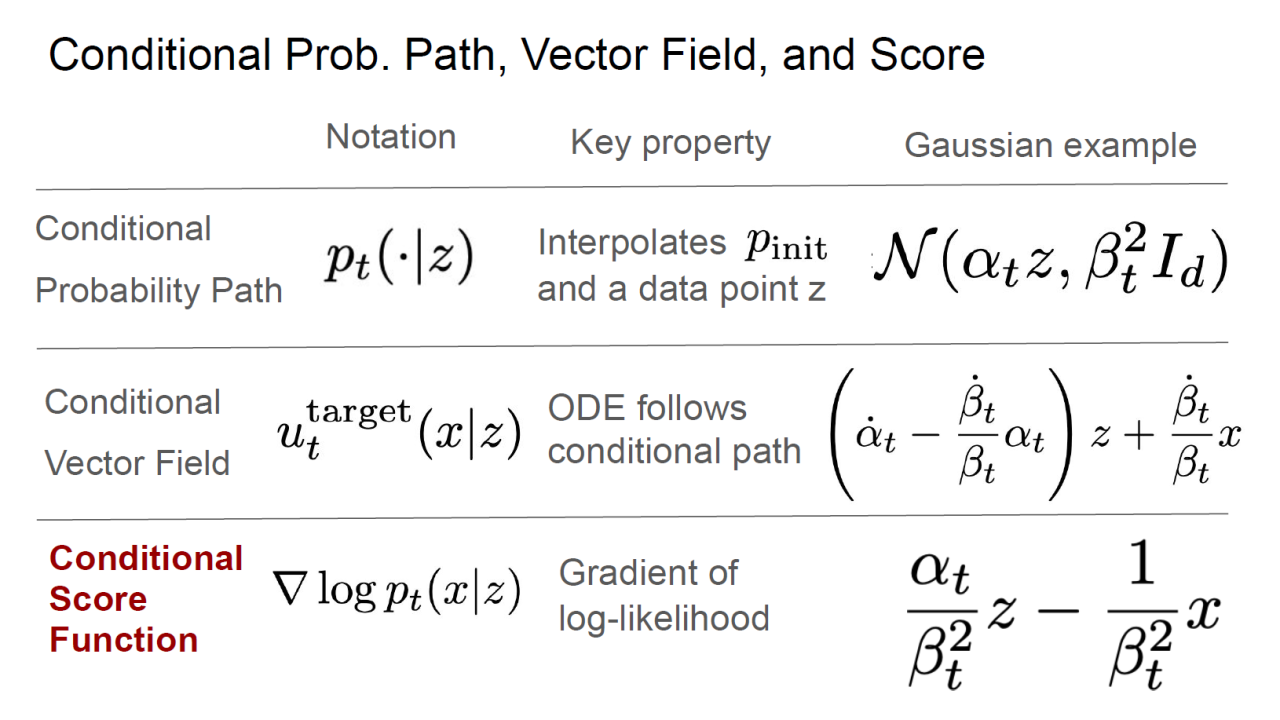
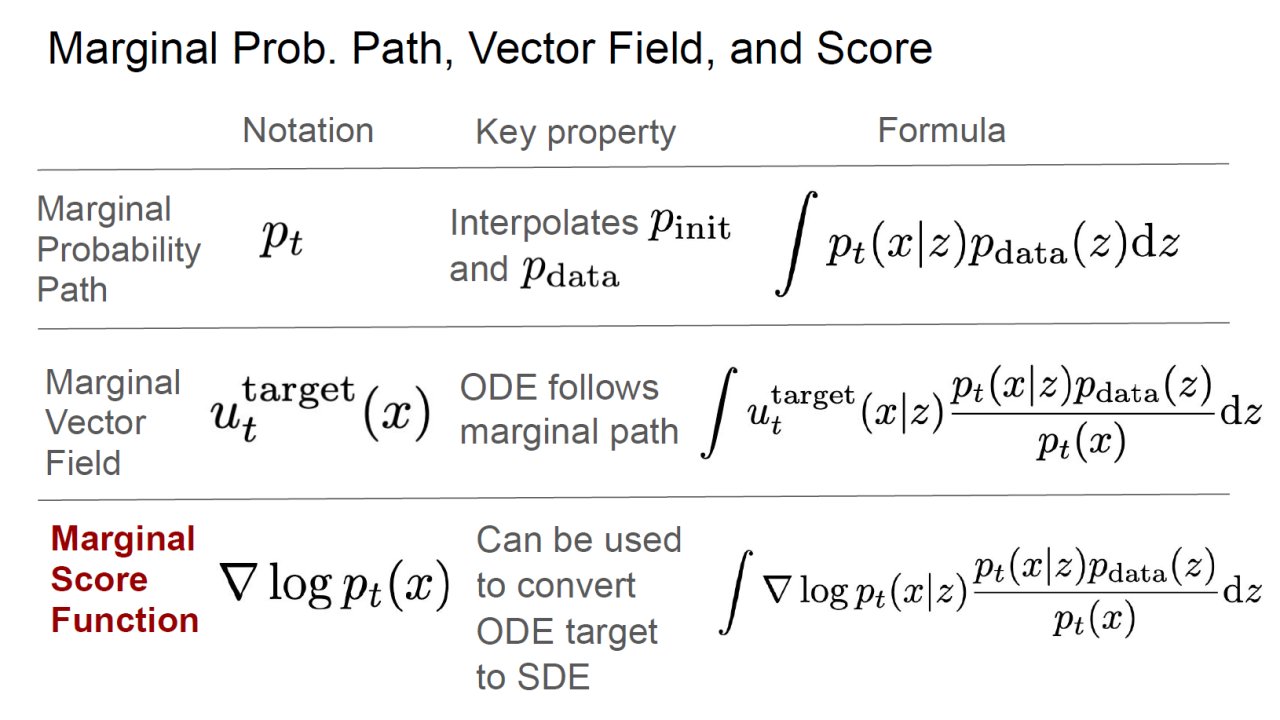
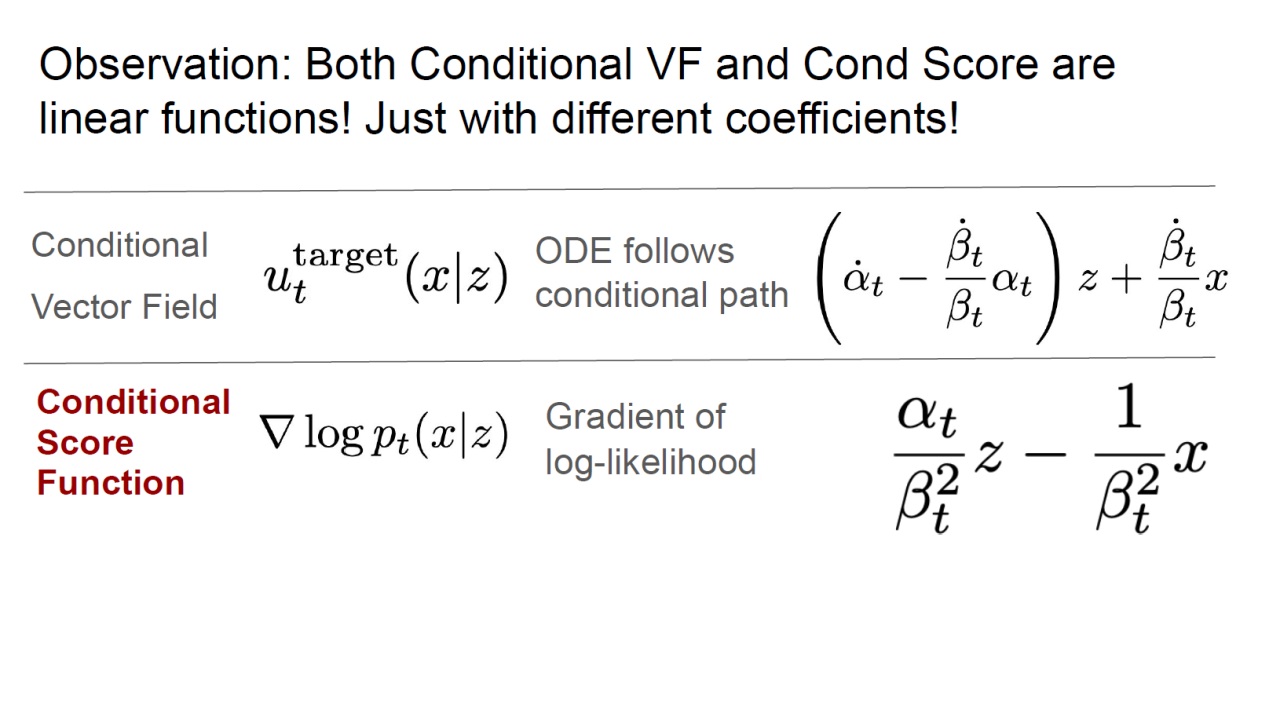
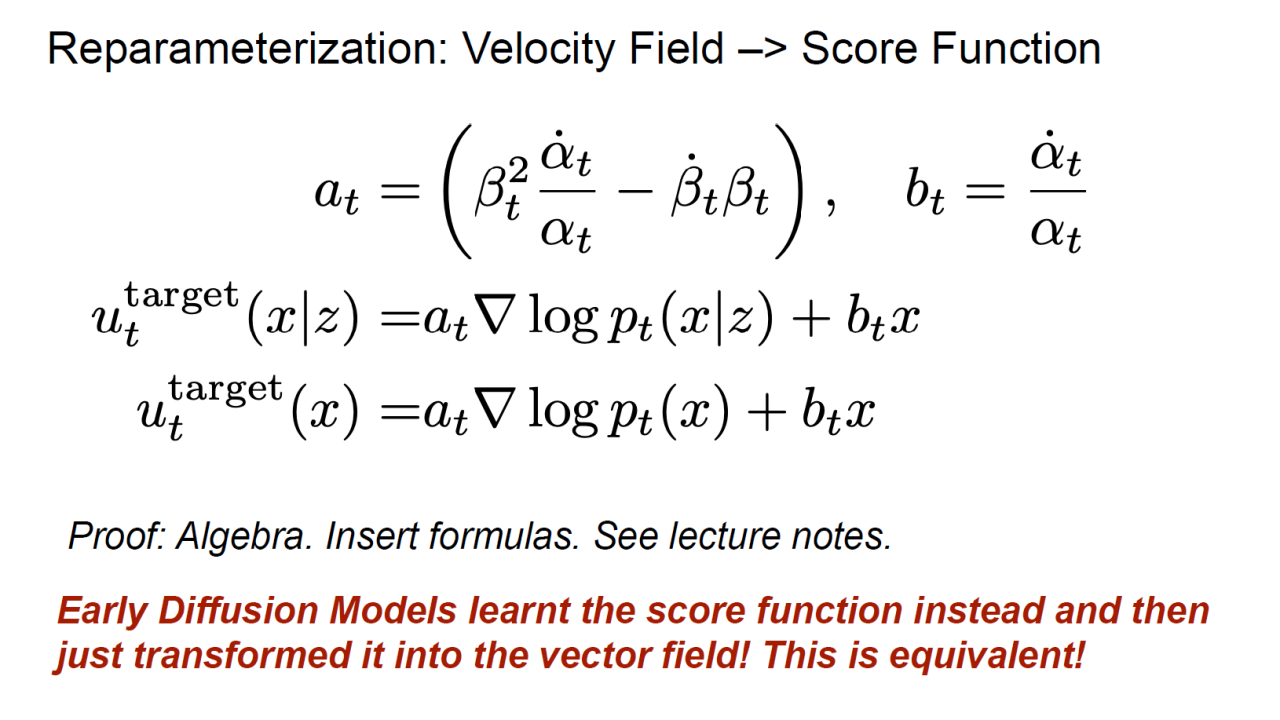
不难发现,高斯概率路径的conditional score function和conditional vector field有非常相似的形式。实际上只需要进行一些简单的代数变换,我们就可以用vector field的形式来表示score function。首先对高斯概率路径的条件向量场公式进行变形可以得到
\[\begin{aligned} u_t^{\text{target}} (x \vert z) &= \bigg( \dot{\alpha_t} - \frac{\dot{\beta_t}}{\beta_t} \alpha_t \bigg) z + \frac{\dot{\beta_t}}{\beta_t} x \\ &= \bigg( \beta_t^2 \frac{\dot{\alpha_t}}{\alpha_t} - \dot{\beta_t} \beta_t \bigg) \bigg( \frac{\alpha_t z - x}{\beta_t^2} \bigg) + \frac{\dot{\alpha_t}}{\alpha_t} x \\ &= \bigg( \beta_t^2 \frac{\dot{\alpha_t}}{\alpha_t} - \dot{\beta_t} \beta_t \bigg) \nabla \log{p_t (x \vert z)} + \frac{\dot{\alpha_t}}{\alpha_t} x \end{aligned}\]记\(a_t = \beta_t^2 \frac{\dot{\alpha_t}}{\alpha_t} - \dot{\beta_t} \beta_t\),\(b_t = \frac{\dot{\alpha_t}}{\alpha_t}\),则有
\[u_t^{\text{target}} (x \vert z) = a_t \nabla \log{p_t (x \vert z)} + b_t x\]对于边缘向量场,只需要按照边缘化技巧进行积分即可
\[\begin{aligned} u_t^\text{target} (x) &= \int u_t^\text{target} (x \vert z) \frac{p_t(x \vert z) \ p_{\text{data}} (z)}{p_t (x)} \mathrm{d} z \\ &= \int [a_t \nabla \log{p_t (x \vert z)} + b_t x] \frac{p_t(x \vert z) \ p_{\text{data}} (z)}{p_t (x)} \ \ \mathrm{d} z \\ &= a_t \nabla \log{p_t (x)} + b_t x \end{aligned}\]因此可以认为score function和vector field是相互等价的。
Score Matching
类似于flow matching算法,score matching同样是使用一个神经网络来表达score function。因此可以定义score matching的损失函数为:
\[\mathcal{L}_{\text{SM}} (\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(x \vert z)} \big[ \| s_t^\theta (x) - \nabla \log p_t(x) \|^2 \big]\]而使用conditional score function作为优化目标的损失函数称为denoising score matching loss:
\[\mathcal{L}_{\text{DSM}} (\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(x \vert z)} \big[ \| s_t^\theta (x) - \nabla \log p_t(x \vert z) \|^2 \big]\]同样地,可以证明二者之间只相差一个常数\(C\)
\[\mathcal{L}_{\text{SM}} (\theta) = \mathcal{L}_{\text{DSM}} (\theta) + C\]这样我们就得到了score matching算法的损失函数以及训练过程。
\begin{algorithm}
\caption{Score Matching Training Procedure (General)}
\begin{algorithmic}
\REQUIRE A dataset of samples $z \sim p_{\text{data}}$, score network $s_t^\theta$
\FOR{each mini-batch of data}
    \STATE Sample a data example $z$ from the dataset
    \STATE Sample a random time $t \sim \text{Unif}_{[0,1]}$
    \STATE Sample $x \sim p_t(\cdot \vert z)$
    \STATE Compute loss $\mathcal{L}(\theta) = \| s_t^\theta (x) - \nabla \log p_t (x \vert z) \|^2$
    \STATE Update the model parameters $\theta$ via gradient descent on $\mathcal{L}(\theta)$
\ENDFOR
\end{algorithmic}
\end{algorithm}
Score Matching for Gaussian Probability Paths
对于高斯概率路径,我们可以直接计算它的conditional score function。
\[\nabla \log p_t (x \vert z) = - \frac{x - \alpha_t z}{\beta_t^2}\]基于此可以得到score matching的损失函数:
\[\begin{aligned} \mathcal{L}_{\text{DSM}} (\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(x \vert z)} \big[ \| s_t^\theta (x) - \nabla \log p_t(x \vert z) \|^2 \big] \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(x \vert z)} \bigg[ \bigg\| s_t^\theta (x) + \frac{x - \alpha_t z}{\beta_t^2} \bigg\|^2 \bigg] \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)} \bigg[ \bigg\| s_t^\theta (\alpha_t z + \beta_t \epsilon) + \frac{\epsilon}{\beta_t} \bigg\|^2 \bigg] \end{aligned}\]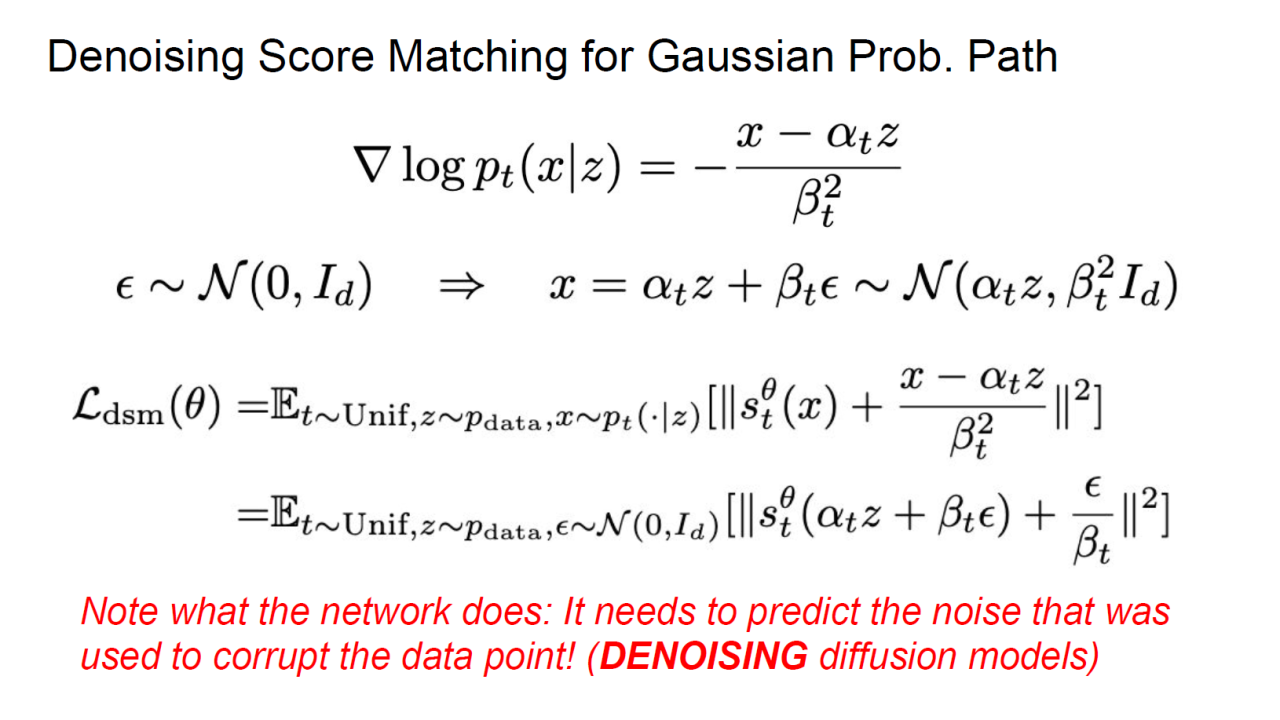
对应的训练过程伪代码如下:
\begin{algorithm}
\caption{Score Matching Training Procedure for Gaussian probability path}
\begin{algorithmic}
\REQUIRE A dataset of samples $z \sim p_{\text{data}}$, score network $s_t^\theta$ or noise predictor $\epsilon_t^\theta$
\REQUIRE Schedulers $\alpha_t$, $\beta_t$ with $\alpha_0 = \beta_1 = 0$, $\alpha_1 = \beta_0 = 1$
\FOR{each mini-batch of data}
    \STATE Sample a data example $z$ from the dataset
    \STATE Sample a random time $t \sim \text{Unif}_{[0,1]}$
    \STATE Sample noise $\epsilon \sim \mathcal{N}(0, I_d)$
    \STATE Set $x_t = \alpha_t z + \beta_t \epsilon$
    \STATE Compute loss $\mathcal{L}(\theta) = \| s_t^\theta (x_t) + \frac{\epsilon}{\beta_t} \|^2$
    \STATE Update the model parameters $\theta$ via gradient descent on $\mathcal{L}(\theta)$
\ENDFOR
\end{algorithmic}
\end{algorithm}
Denoising Diffusion Models
从扩散模型的发展历史来看,最早获得人们广泛关注的扩散模型是基于降噪器(denoiser)的模型,而非score matching。实际上二者完全等价,只是从两个不同角度对同一个对象进行参数化。这里以高斯概率路径为例进行推导。回忆高斯概率路径的conditional score function具有解析形式:
\[s_t (x) = \nabla \log p_t (x \vert z) = - \frac{x - \alpha_t z}{\beta_t^2}\]同时\(t\)时刻采样出的带噪声数据可以表示为
\[x_t = \alpha_t z + \beta_t \epsilon_t\]把上述两式结合起来可以得到噪声\(\epsilon_t\)的表达式
\[\epsilon_t (x) = \frac{x - \alpha_t z}{\beta_t} = -\beta_t s_t (x)\]将上式代入到score matching的损失函数中,可以得到重新参数化的损失函数
\[\begin{aligned} \mathcal{L}_{\text{DSM}} (\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)} \bigg[ \bigg\| s_t^\theta (\alpha_t z + \beta_t \epsilon) + \frac{\epsilon}{\beta_t} \bigg\|^2 \bigg] \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)} \bigg[ \frac{1}{\beta_t^2} \bigg\| \beta_t s_t^\theta (\alpha_t z + \beta_t \epsilon) + \epsilon \bigg\|^2 \bigg] \\ &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)} \bigg[ \frac{1}{\beta_t^2} \bigg\| \epsilon_t^\theta (\alpha_t z + \beta_t \epsilon) - \epsilon \bigg\|^2 \bigg] \end{aligned}\]上式表明score matching可以理解为对添加的噪声进行预测,这也是为什么conditional score matching使用的损失函数也称为denoising score matching的原因。在实践中为了防止\(\beta_t \to 0\)时产生数值稳定性问题,在训练时往往会直接丢掉\(1 / \beta_t^2\)一项,这样就得到了DDPM的损失函数
\[\mathcal{L}_{\text{DDPM}} (\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)} \big[ \| \epsilon_t^\theta (\alpha_t z + \beta_t \epsilon) - \epsilon \|^2 \big]\]Sampling with SDEs
SDE Extension Trick
当我们训练好score function后,接下来的问题是如何使用它进行采样。实际上score function与边缘向量场以及SDE有着密切的联系,对于给定的边缘向量场\(u_t^{\text{target}} (X_t)\)以及扩散系数\(\sigma_t \geq 0\),可以定义对应的随机动力学(stochastic dynamics)为
\[\mathrm{d} X_t = \bigg[ u_t^{\text{target}} (X_t) + \frac{\sigma_t^2}{2} \nabla \log p_t (X_t) \bigg] \mathrm{d} t + \sigma_t \mathrm{d} W_t\]注意这里\(\sigma_t\)是可以任意指定的,理论上我们可以使用任意非负的\(\sigma_t\)来实现采样,它与模型的训练过程无关。上式中\(\sigma_t \mathrm{d} W_t\)表示对数据添加噪声的过程,与数据本身无关;而\(\frac{\sigma_t^2}{2} \nabla \log p_t (X_t)\)则可以理解为对噪声数据进行修正,修正量取决于当前状态的score function。
对于高斯概率路径,我们可以直接推导它的随机动力学为
\[\mathrm{d} X_t = \bigg[ \bigg( a_t + \frac{\sigma_t^2}{2} \bigg) s_t^\theta (X_t)+ b_t X_t \bigg] \mathrm{d} t + \sigma_t \mathrm{d} W_t\]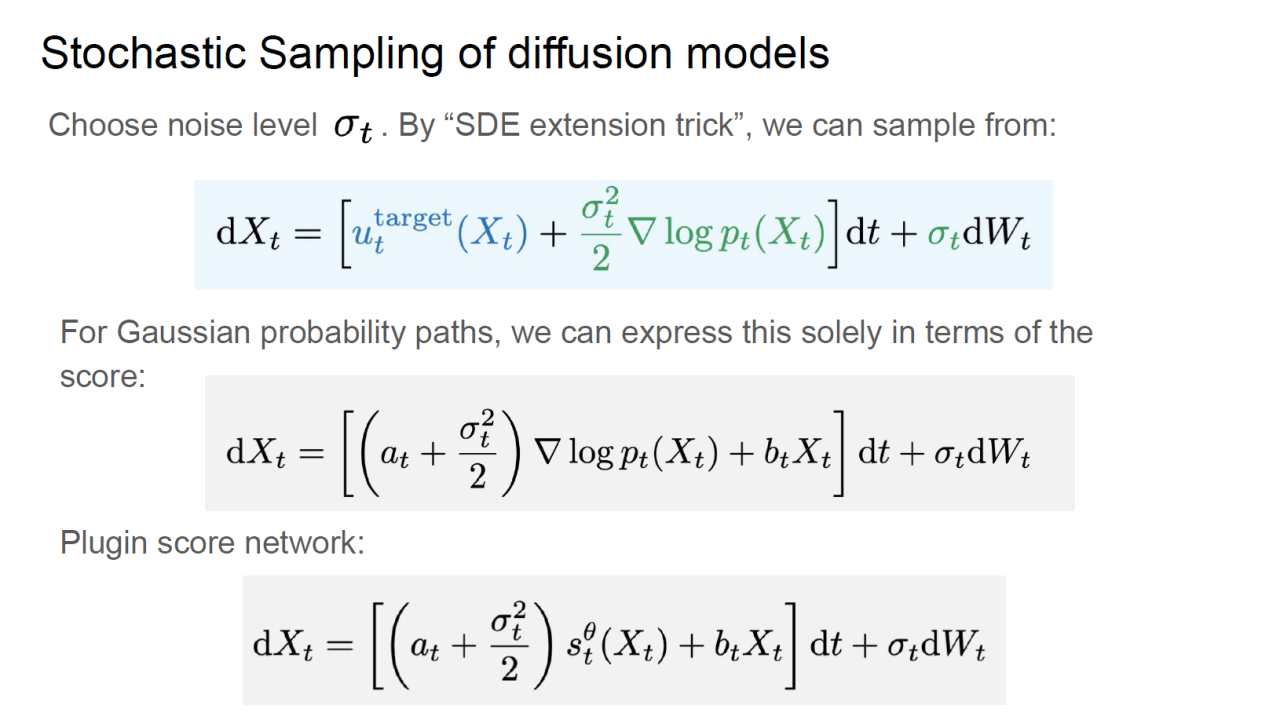
Fokker-Planck Equation
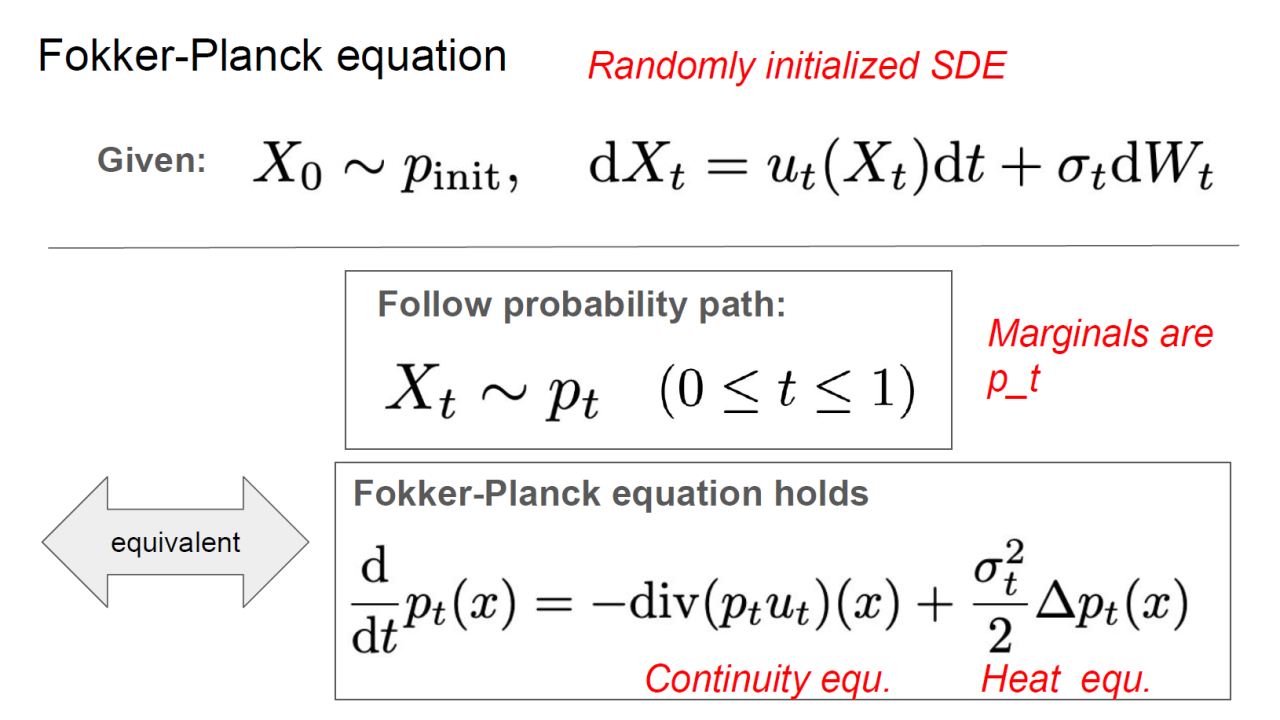
随机动力学的证明需要引入Fokker-Planck方程,它可以理解为考虑了扩散过程的连续性方程。Fokker-Planck方程指出随机微分方程
\[\mathrm{d} X_t = u_t (X_t) \mathrm{d} t + \sigma_t \mathrm{d} W_t, \quad X_0 \sim p_\text{init}\]其概率密度函数\(p_t (x)\)满足
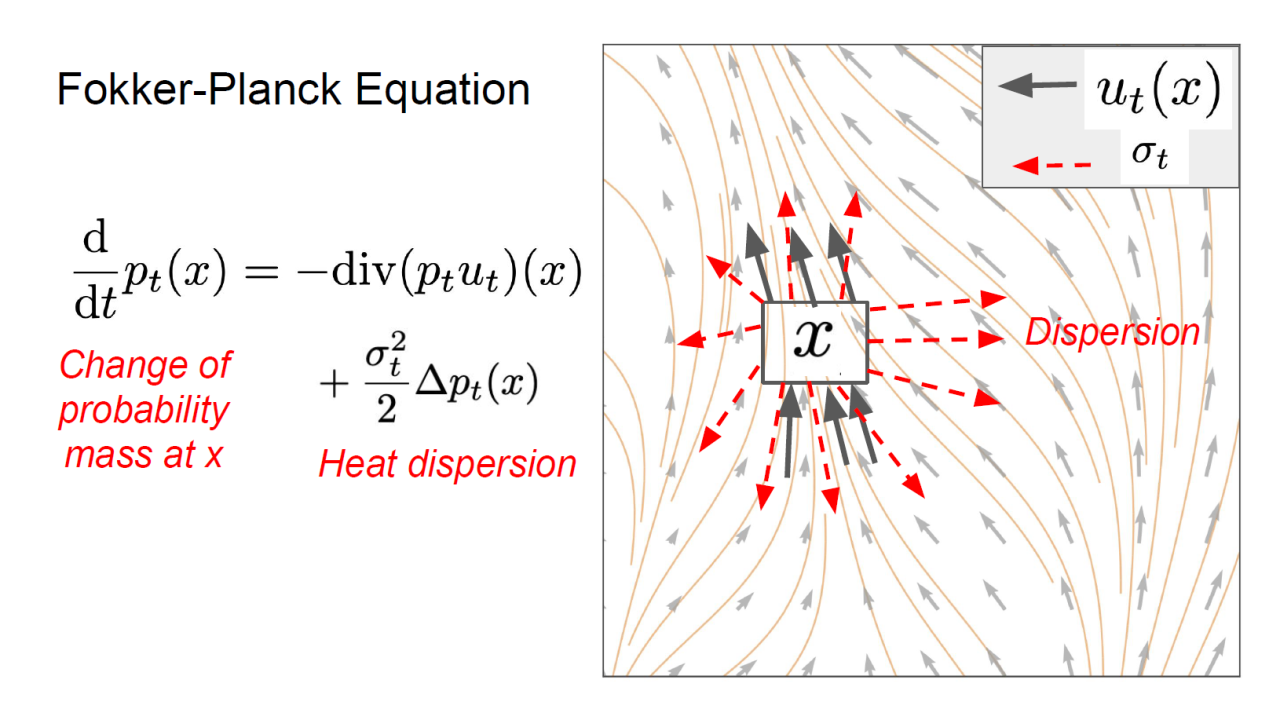
\[\partial_t p_t (x) = - \nabla \cdot (p_t u_t) (x) + \frac{\sigma_t^2}{2} \Delta p_t (x)\]Fokker-Planck方程的物理意义在于:概率密度的时间演化由两部分构成,一部分来自向量场的输运,另一部分则来自随机噪声引起的扩散。
接下来我们将使用Fokker-Planck方程来证明随机动力学的正确性。根据边缘向量场的连续性方程有
\[\begin{aligned} \partial_t p_t(x) &= -\nabla \cdot (p_t u_t^\text{target}) (x) \\ &= -\nabla \cdot (p_t u_t^\text{target}) (x) - \frac{\sigma_t^2}{2} \Delta p_t (x) + \frac{\sigma_t^2}{2} \Delta p_t (x) \end{aligned}\]上式中\(\Delta\)为Laplace算子,它和散度算子\(\nabla \cdot\)的关系为
\[\Delta w_t (x) = \sum_{i=1}^d \frac{\partial^2}{\partial x_i^2} w_t(x) = \nabla \cdot \big( \nabla w_t \big) (x)\]其中\(w_t (x) : \mathbb{R}^d \rightarrow \mathbb{R}\)为任意标量场。利用Laplace算子和散度算子的关系,可以得到
\[\begin{aligned} \partial_t p_t(x) &= -\nabla \cdot (p_t u_t^\text{target}) (x) - \frac{\sigma_t^2}{2} \Delta p_t (x) + \frac{\sigma_t^2}{2} \Delta p_t (x) \\ &= -\nabla \cdot (p_t u_t^\text{target}) (x) - \nabla \cdot \bigg( \frac{\sigma_t^2}{2} \nabla p_t \bigg) (x) + \frac{\sigma_t^2}{2} \Delta p_t (x) \\ &= -\nabla \cdot (p_t u_t^\text{target}) (x) - \nabla \cdot \bigg( p_t \frac{\sigma_t^2}{2} \nabla \log p_t \bigg) (x) + \frac{\sigma_t^2}{2} \Delta p_t (x) \\ &= -\nabla \cdot \bigg( p_t \bigg[ u_t^\text{target} + \frac{\sigma_t^2}{2} \nabla \log p_t \bigg] \bigg) (x) + \frac{\sigma_t^2}{2} \Delta p_t (x) \end{aligned}\]对比Fokker-Planck方程可知,上式对应的SDE其漂移项为\(u_t^\text{target} + \frac{\sigma_t^2}{2} \nabla \log p_t\)、扩散系数为\(\sigma_t\)。换言之,只要将漂移项取为\(u_t^\text{target} + \frac{\sigma_t^2}{2} \nabla \log p_t\),随机动力学给出的概率密度演化就与原来的连续性方程完全一致,也就证明了随机动力学的正确性。
Why Stochastic Dynamics?
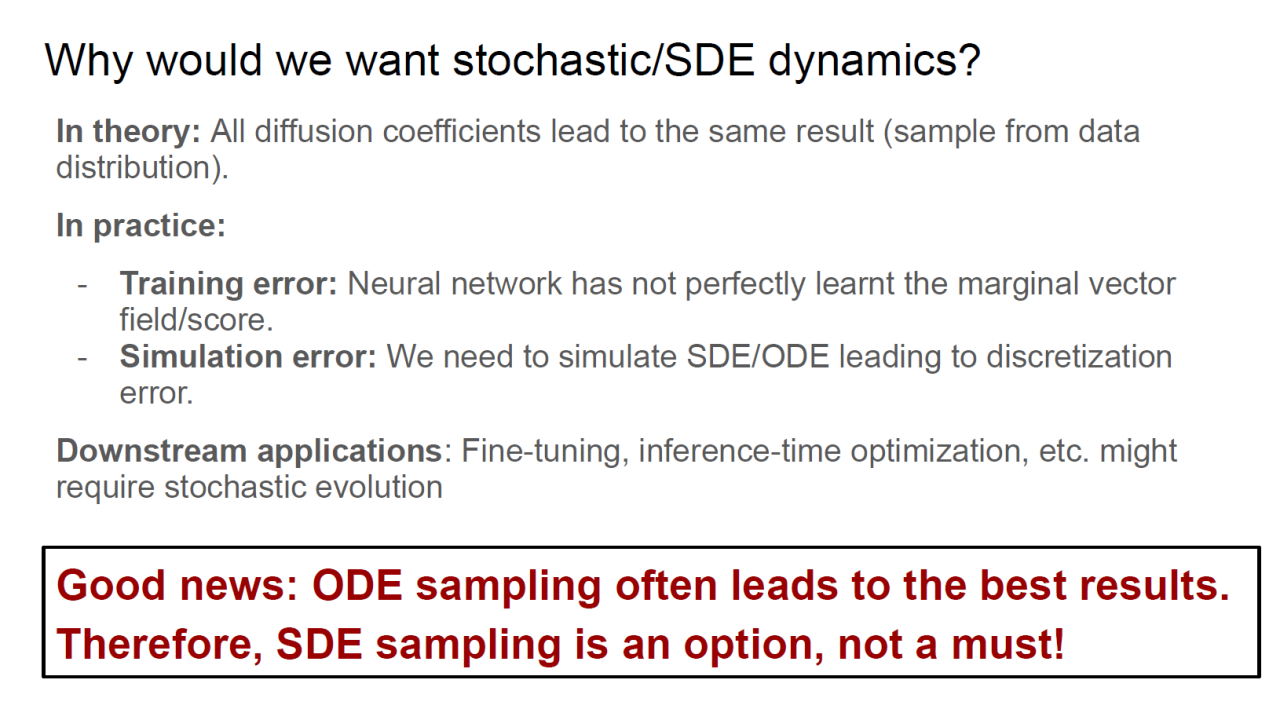
实际上我们到目前为止还没有回答这样一个问题:既然已经有了flow matching和向量场,为什么还要使用随机动力学来进行采样?这主要是因为生成模型的一些下游任务需要引入随机性。
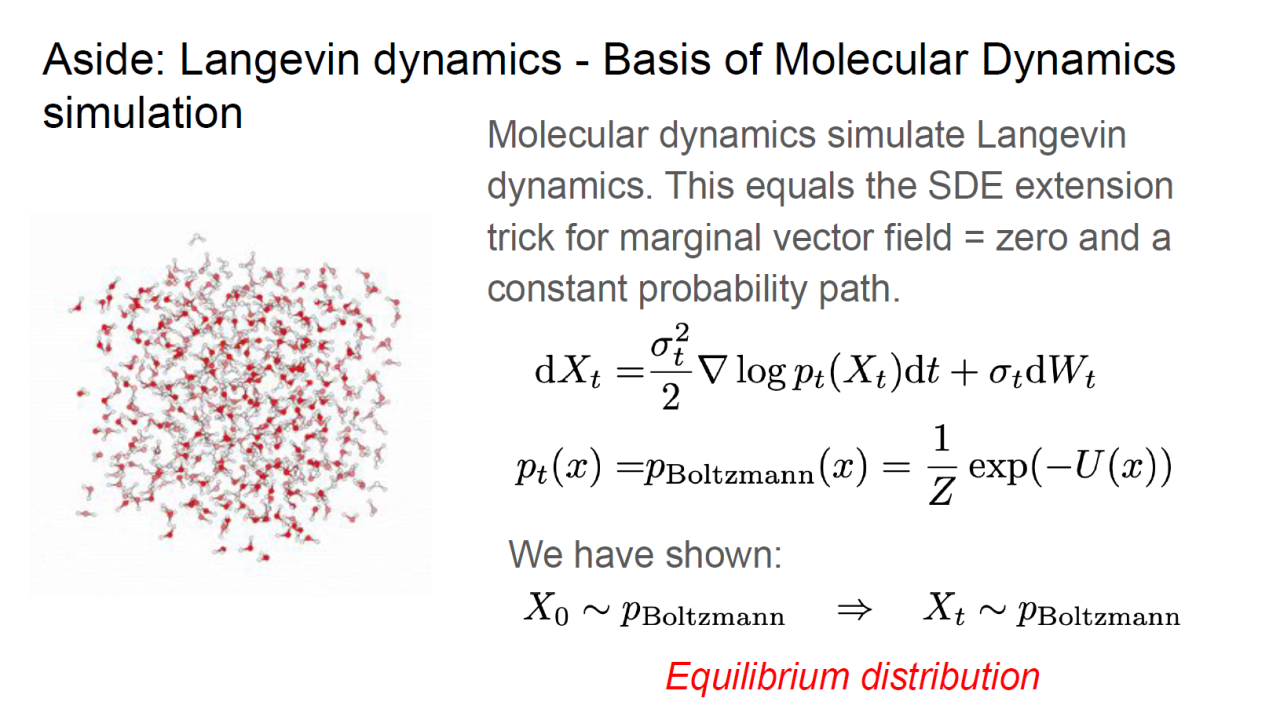
同时,我们推导的随机动力学也与Langevin动力学(Langevin dynamics)有一定的联系。假设概率路径\(p_t (x)\)与时间\(t\)无关,即\(p_t(x) = p(x)\),由连续性方程有
\[\partial_t p_t(x) = -\nabla \cdot (p_t u_t^\text{target}) (x) = 0\]满足该条件的最简单取法是令边缘向量场为零,即
\[u_t^\text{target} (x) = 0\]在此基础上结合随机动力学公式,可以得到Langevin动力学的SDE为
\[\mathrm{d} X_t = \frac{\sigma_t^2}{2} \nabla \log p (X_t) \mathrm{d} t + \sigma_t \mathrm{d} W_t\]实际上\(p(x)\)给出了Langevin动力学的平稳分布(stationary distribution),而利用该SDE可以将任意初始分布\(p' \neq p\)以随机扩散的方式收敛到平稳分布\(p(x)\)上。这一性质使得Langevin动力学在分子模拟、MCMC等领域中都有着重要的应用。
本节课的主要内容可以总结如下: