MIT 6.S184课程笔记4-Classifier-Free Guidance
这个系列是MIT 6.S184 - Introduction to Flow Matching and Diffusion Models的同步课程笔记。本门课程面向希望深入理解流模型与扩散模型的学生和研究者,从最基础的数学工具出发,逐步推导这些模型背后的数学原理,并介绍相应的训练与采样算法。本节课主要介绍条件引导生成的相关技术。
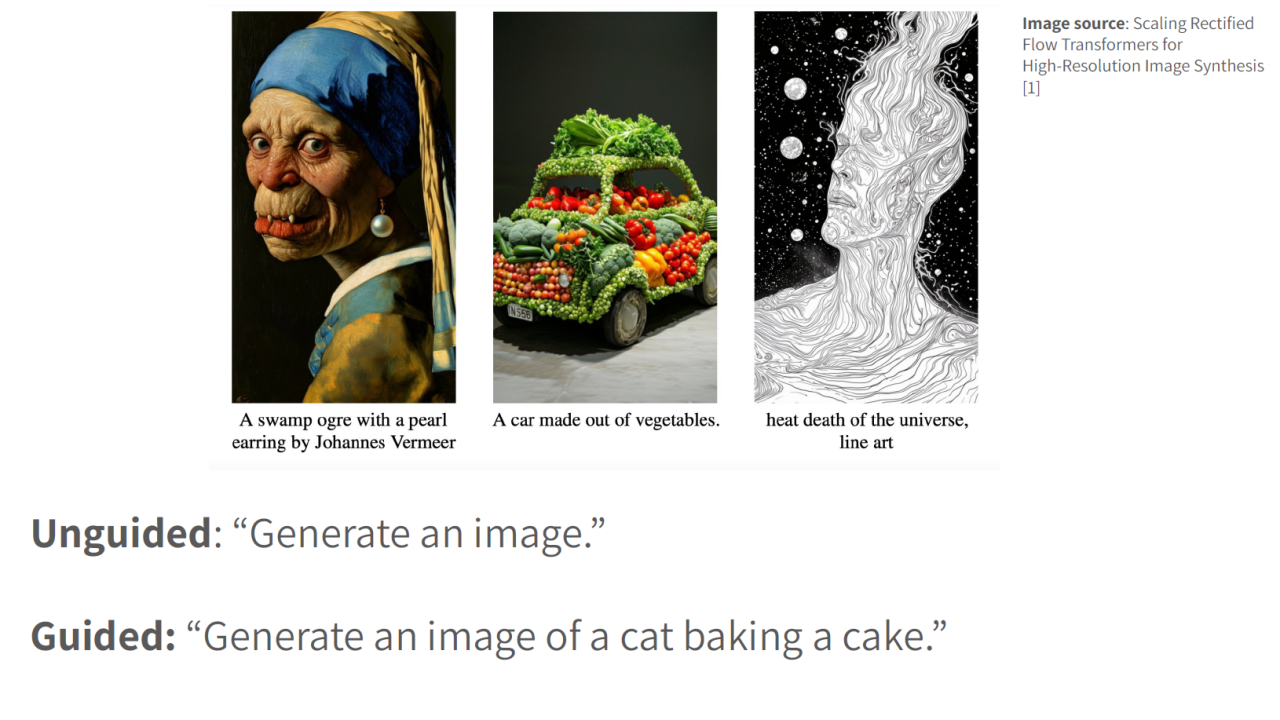
前面的课程中我们主要关注的是通用的生成算法。然而在很多实际场景中,我们往往需要根据一些用户的输入或提示来控制生成的内容。例如在图像生成任务中,我们往往需要根据用户的描述来生成对应的图像。本节课我们将介绍如何使用条件引导来控制数据生成的过程。
Vanilla Guidance
首先我们来介绍最基础的条件生成方法。在条件生成的任务中,我们的输入数据为带有标签的一对
\[(z, y) \sim p_{\text{data}}\]其中\(z \in \mathbb{R}^d\)表示高维数据,而\(y\)则是具体数据对应的标签/prompt。因此我们的学习目标可以形式化为学习一个引导向量场(guided vector field)
\[u_t^\theta (x \vert y) : \mathbb{R}^d \times \mathcal{Y} \times [0, 1] \to \mathbb{R}^d\]而对应的损失函数则可以表示为
\[\mathcal{L}_{\text{CFM}}^{\text{guided}} (\theta) = \mathbb{E}_{(z,y) \sim p_{\text{data}}(z,y), \ t \sim \text{Unif}[0,1], \ x \sim p_t (\cdot \vert z)} \big[\| u_t^\theta (x \vert y) - u_t^\text{target} (x \vert z) \|^2 \big]\]不难发现上式损失函数和训练flow matching的损失函数并没有本质区别,只是在计算向量场\(u_t^\theta (x \vert y)\)时需要将提示\(y\)作为额外的输入。类似地,我们可以得到最基础的条件引导生成算法如下:
\begin{algorithm}
\caption{Guided Sampling Procedure}
\begin{algorithmic}
\REQUIRE A trained guided vector field $u_t^\theta (x \vert y)$
\STATE Select a prompt $y \in \mathcal{Y}$, such as "a cat baking a cake"
\STATE Initialize $X_0 \sim p_\text{init}$
\STATE Simulate $\mathrm{d} X_t = u_t^\theta (X_t \vert y) \mathrm{d} t$ from $t = 0$ to $t = 1$
\end{algorithmic}
\end{algorithm}
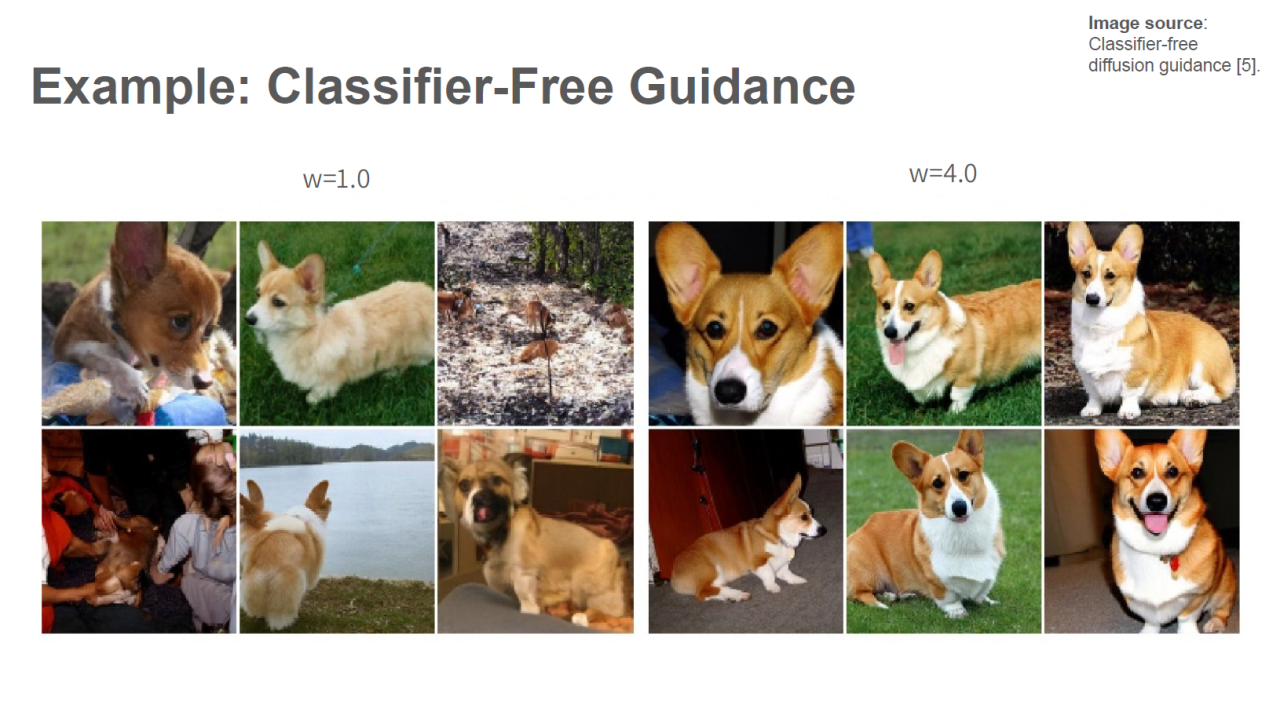
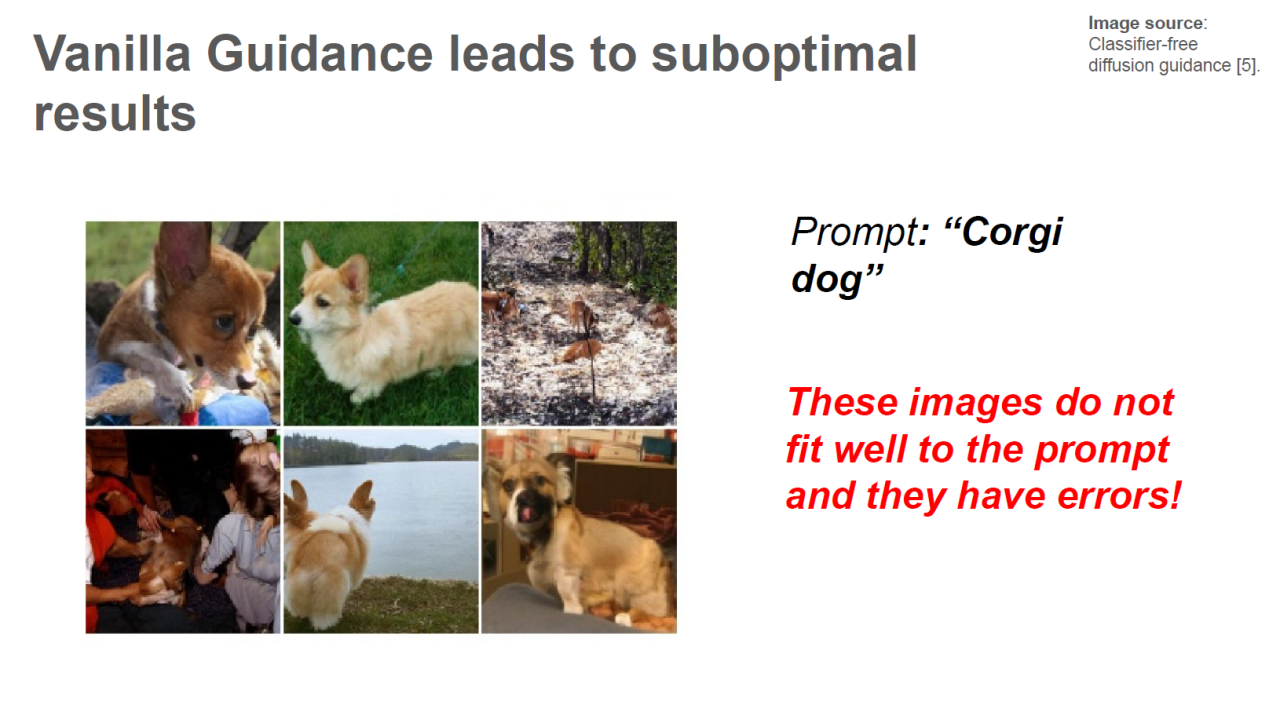
从直觉上讲使用上述训练算法应该能够实现基于promt的条件引导生成。然而实践中发现使用上述算法训练的模型往往不能得到理想的生成结果,甚至生成的数据本身也存在一些错误。
Classifier Guidance
要解释为什么vanilla guidance算法会出现问题则需要深入学习到的向量场\(u_t^\theta (x \vert y)\)。首先根据Bayes法则将条件概率\(p_t (x \vert y)\)展开为
\[p_t (x \vert y) = \frac{p_t (y \vert x) p_t (x)}{p_t (y)}\] \[\log{p_t (x \vert y)} = \log{p_t (y \vert x)} + \log{p_t (x)} - \log{p_t (y)}\]对上式求梯度得到
\[\begin{aligned} \nabla_x \log{p_t (x \vert y)} &= \nabla_x \log{p_t (y \vert x)} + \nabla_x \log{p_t (x)} - \nabla_x \log{p_t (y)} \\ &= \nabla_x \log{p_t (y \vert x)} + \nabla_x \log{p_t (x)} \end{aligned}\]上式说明,条件概率\(p_t (x \vert y)\)的score function包含两项,其中一项为无条件概率\(p_t (x)\)对应的score function,而另一项则是分类器\(p_t (y \vert x)\)对应的score function。
对于高斯概率路径,其向量场可以表示为对应的score function,这样就可以把条件引导向量场\(u_t^\text{target} (x \vert y)\)表示为
\[\begin{aligned} u_t^\text{target} (x \vert y) &= a_t \nabla \log{p_t (x \vert y)} + b_t x \\ &= b_t x + a_t \big( \nabla_x \log{p_t (y \vert x)} + \nabla_x \log{p_t (x)} \big) \\ &= u_t^\text{target} (x) + a_t \nabla \log{p_t (y \vert x)} \end{aligned}\]上式表明,条件引导向量场\(u_t^\text{target} (x \vert y)\)可以分解为两部分:第一项\(u_t^\text{target} (x)\)是无条件向量场与promt无关,而第二项\(a_t \nabla \log{p_t (y \vert x)}\)则对应分类器的score function。
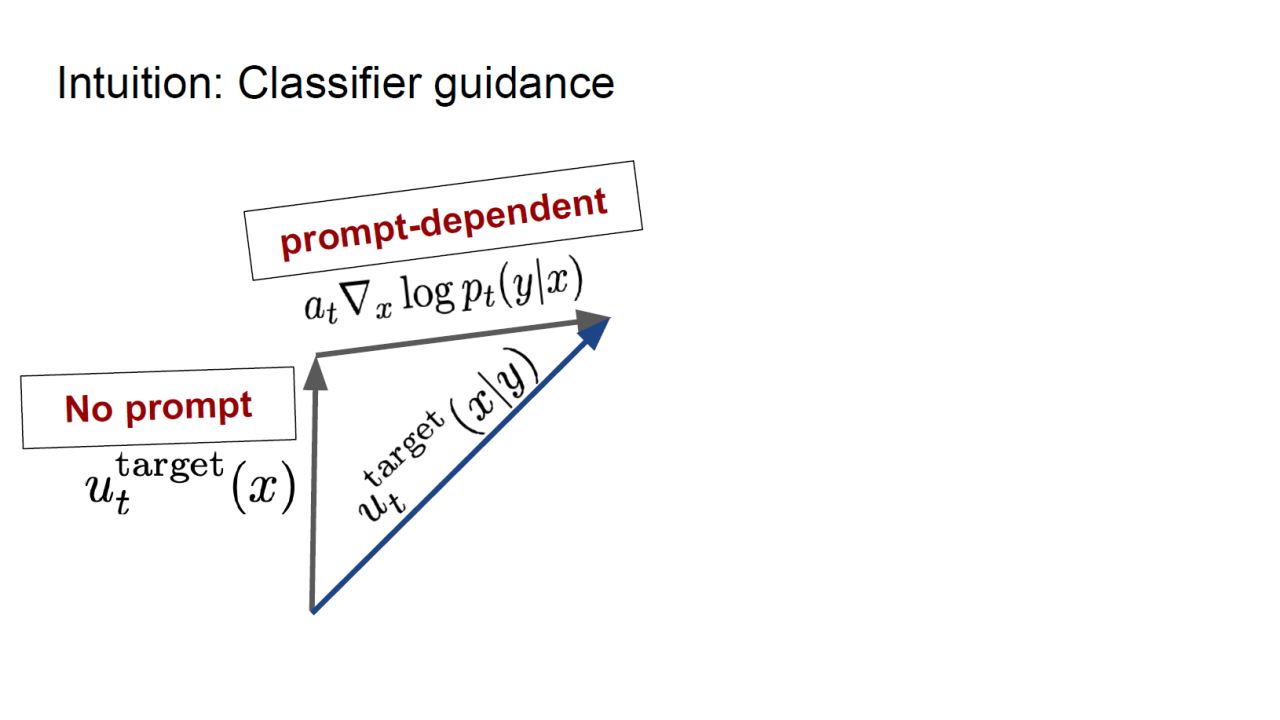
在这一观察下,如果我们可以调整来自promt分类器的score function,则可以实现更好更可控的生成效果。使用这一思路进行训练的过程称为classifier guidance,可以表示为
\[\tilde{u}_t (x \vert y) = u_t^\text{target} (x) + w a_t \nabla \log{p_t (y \vert x)}, \quad w > 1\]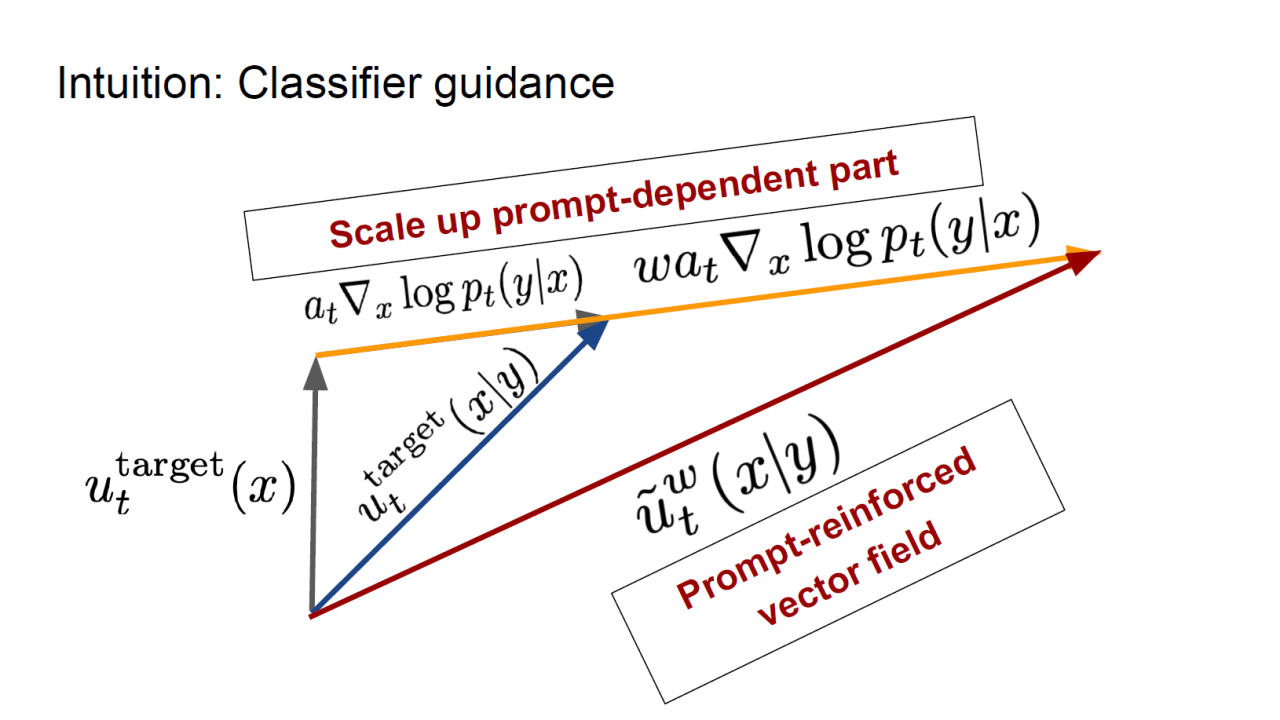
Classifier-Free Guidance
classifier guidance的一个缺陷在于我们需要单独训练一个分类器\(p_t (y \vert x)\),而这个分类器对于生成任务来说往往是多余的。实际上我们可以避开这个分类器,利用score function和Bayes法则可以将分类器重新表示为
\[\nabla \log{p_t (y \vert x)} = \nabla \log{p_t (x \vert y)} - \nabla \log{p_t (x)}\]将上式代回完整的向量场得到
\[\begin{aligned} \tilde{u}_t (x \vert y) &= u_t^\text{target} (x) + w a_t \nabla \log p_t (y \vert x) \\ &= u_t^\text{target} (x) + w a_t \big( \nabla \log p_t (x \vert y) - \nabla \log p_t (x) \big) \\ &= u_t^\text{target} (x) - \big( w b_t x + w a_t \nabla \log p_t (x) \big) + \big( w b_t x + w a_t \nabla \log p_t (x \vert y) \big) \\ &= (1 - w) u_t^\text{target} (x) + w u_t^\text{target} (x \vert y) \end{aligned}\]上式表明,完整的引导向量场可以分解为两个向量场的加权和,其中\((1 - w) u_t^\text{target} (x)\)对应无条件向量场,而\(w u_t^\text{target} (x \vert y)\)则对应把prompt也作为输入的向量场。因此,我们只需要训练两个向量场并且将它们通过权重\(w\)进行组合起来就能够得到完整的引导向量场。
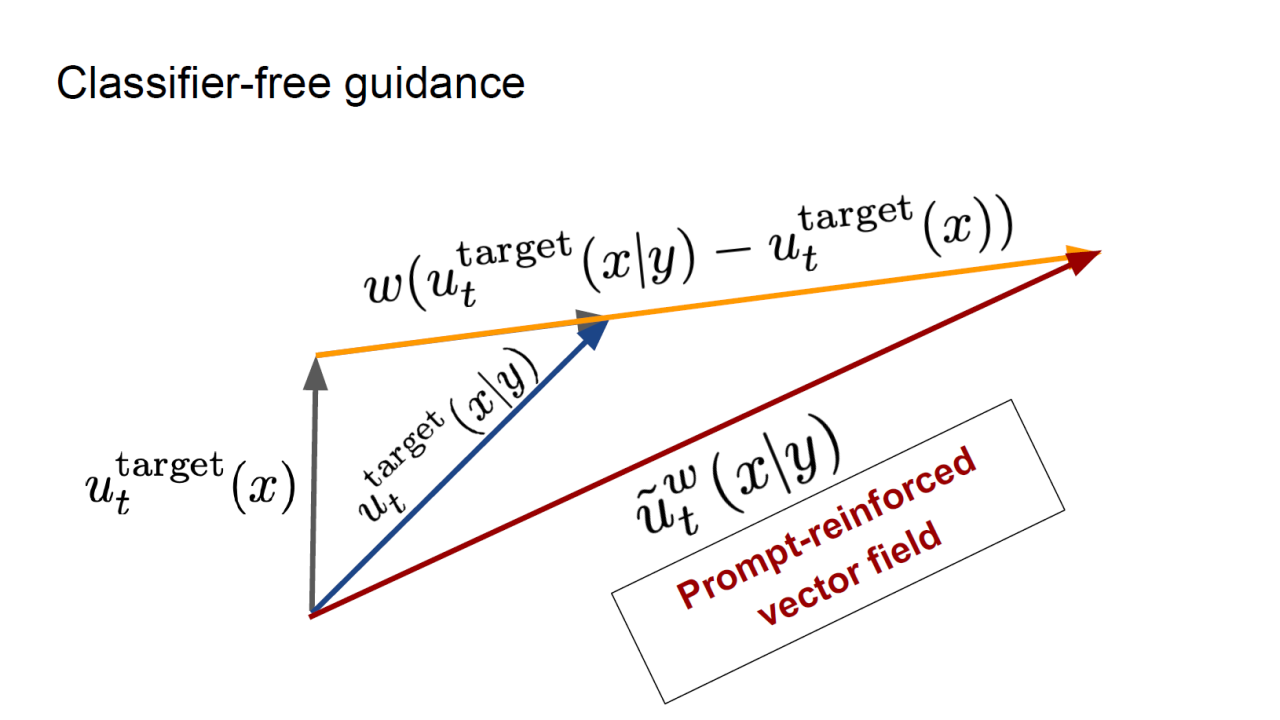
在实践中一般不会专门训练两个向量场,而是为无条件向量场\(u_t^\text{target}\)设置一个专门的空promt,即\(u_t^\text{target} (x) := u_t^\text{target} (x \vert \varnothing)\),并且在训练时按照一定的概率将采样出的的promt置空。这样只需要训练一个向量场即可,对应的训练过程如下。
\begin{algorithm}
\caption{Classifier-free guidance training for Gaussian probability path $p_t (x \vert z) = \mathcal{N} (x; \alpha_t z, \beta_t^2 I_d)$}
\begin{algorithmic}
\REQUIRE Paired dataset $(z, y) \sim p_{\text{data}}$, neural network $u_t^\theta$
\FOR{each mini-batch of data}
    \STATE Sample a data example $(z, y)$ from the dataset
    \STATE Sample a random time $t \sim \text{Unif}_{[0,1]}$
    \STATE Sample noise $\epsilon \sim \mathcal{N}(0, I_d)$
    \STATE Set $x = \alpha_t z + \beta_t \epsilon$
    \STATE With probability $p$ drop label: $y \leftarrow \varnothing$
    \STATE Compute loss $\mathcal{L}(\theta) = \| u_t^\theta (x \vert y) - (\dot{\alpha_t} z + \dot{\beta_t} \epsilon) \|^2$
    \STATE Update the model parameters $\theta$ via gradient descent on $\mathcal{L}(\theta)$
\ENDFOR
\end{algorithmic}
\end{algorithm}
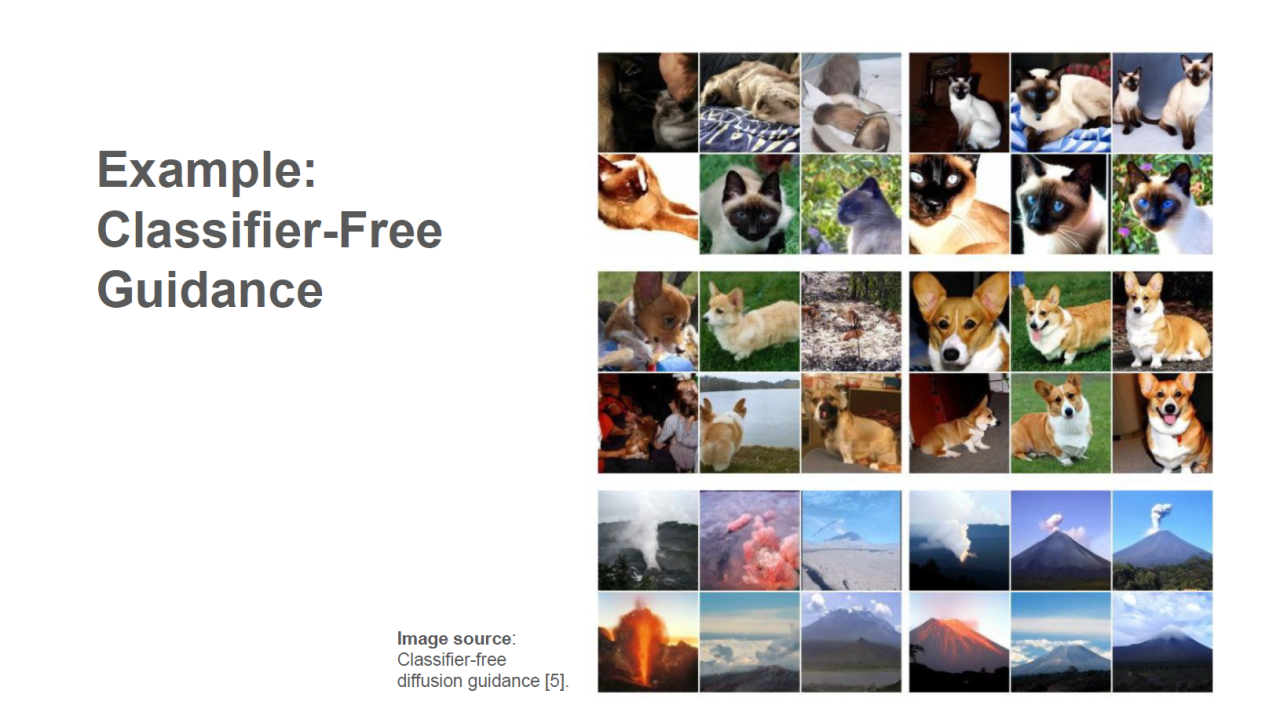
训练完成后,使用CFG进行采样的方式与之前的采样算法完全相同,唯一的区别是使用加权的向量场
\[u_t^{\theta, w} (x) = (1 - w) u_t^\theta (x \vert \varnothing) + w u_t^\theta (x \vert y)\]对应的采样过程如下:
\begin{algorithm}
\caption{Classifier-Free Guidance Sampling Procedure}
\begin{algorithmic}
\REQUIRE A trained guided vector field $u_t^\theta (x \vert y)$
\STATE Select a prompt $y \in \mathcal{Y}$, or take $y = \varnothing$ for unguided sampling
\STATE Select a guidance scale $w > 1$
\STATE Initialize $X_0 \sim p_\text{init}$
\STATE Simulate $\mathrm{d} X_t = \big[ (1 - w) u_t^\theta (X_t \vert \varnothing) + w u_t^\theta (X_t \vert y) \big] \mathrm{d} t$ from $t = 0$ to $t = 1$
\end{algorithmic}
\end{algorithm}
目前成熟的文生图模型基本都是基于上述classifier-free guidance的框架来实现的。