MIT 6.S184课程笔记1-Flow and Diffusion Models
这个系列是MIT 6.S184 - Introduction to Flow Matching and Diffusion Models的同步课程笔记。本门课程面向希望深入理解流模型与扩散模型的学生和研究者,从最基础的数学工具出发,逐步推导这些模型背后的数学原理,并介绍相应的训练与采样算法。本节课主要介绍生成模型的基本概念,以及流模型与扩散模型的整体框架。
生成式模型是如今AI社区最为火热的话题之一。从图像生成到视频生成,再到如今已经取得广泛应用的大语言模型,这些应用的背后都是生成式模型在发挥作用。尽管这些场景中的数据类型各不相同,但它们大多基于同一套算法,也就是本门课程将要着重讨论的流模型与扩散模型。
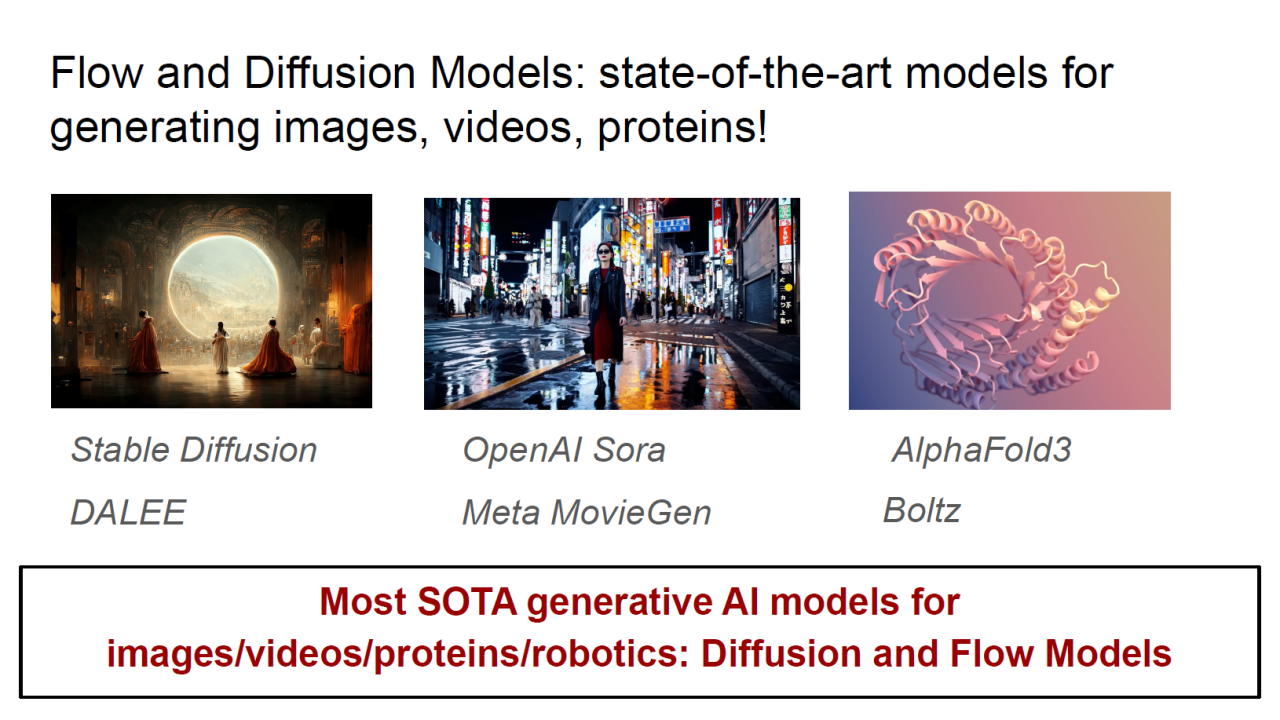
与其它同类课程相比,本门课程更关注流模型与扩散模型背后的数学原理。具体来说,我们会借助ODE和SDE这样的数学工具来理解模型的数学本质,同时也会通过lab动手实现相关的模型和算法。
From Generation to Sampling
为了方便计算机处理,我们通常会把不同类型的数据统一结构化为多维数组。以RGB图像为例,图像在计算机中是以[H, W, 3]尺寸的3维数组表示的。类似地,视频可以表示为[T, H, W, 3]的4维数组,而分子结构则可以表示为[N, 3]的2维数组。显然,这些结构化的数据本质上都可以用向量来表示。
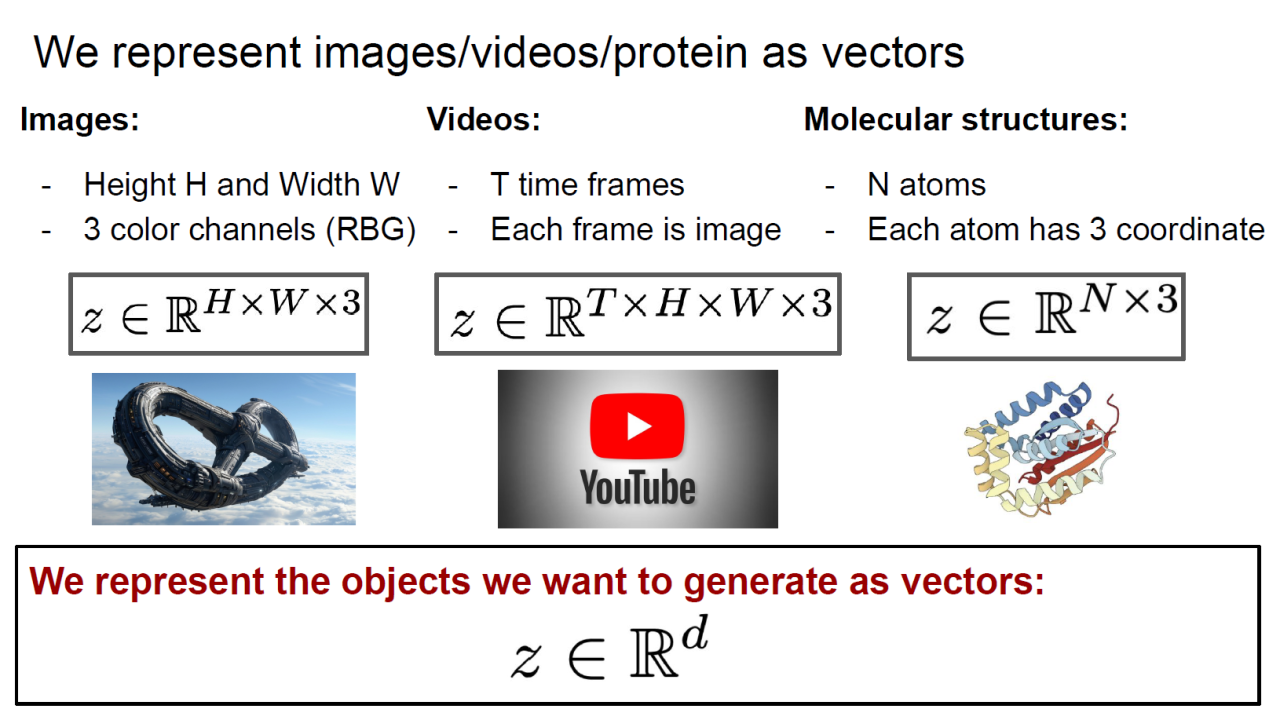
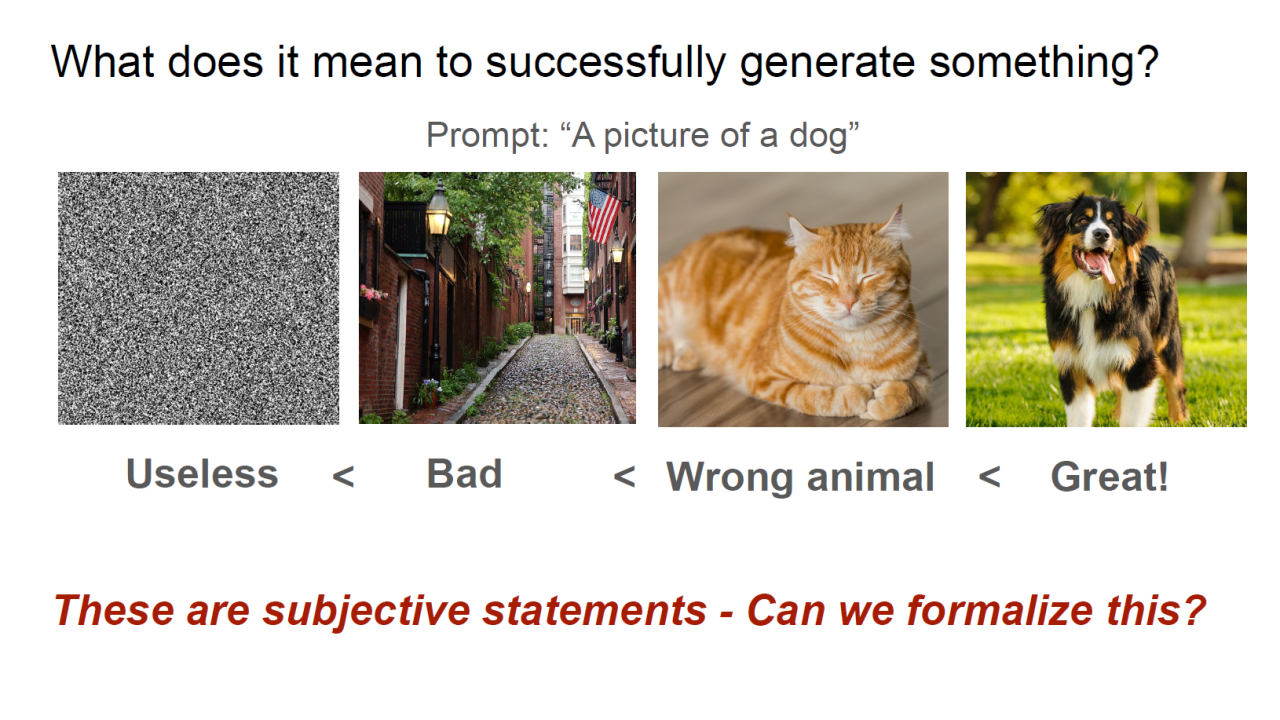
对于结构化数据的生成问题,我们可以将其形式化为高维向量的概率分布问题。具体来说,我们在高维空间上定义一个概率密度函数,每个数据点上的函数值对应该样本出现的概率(密度)。这样,生成结果的好坏就可以用概率密度的大小来衡量。
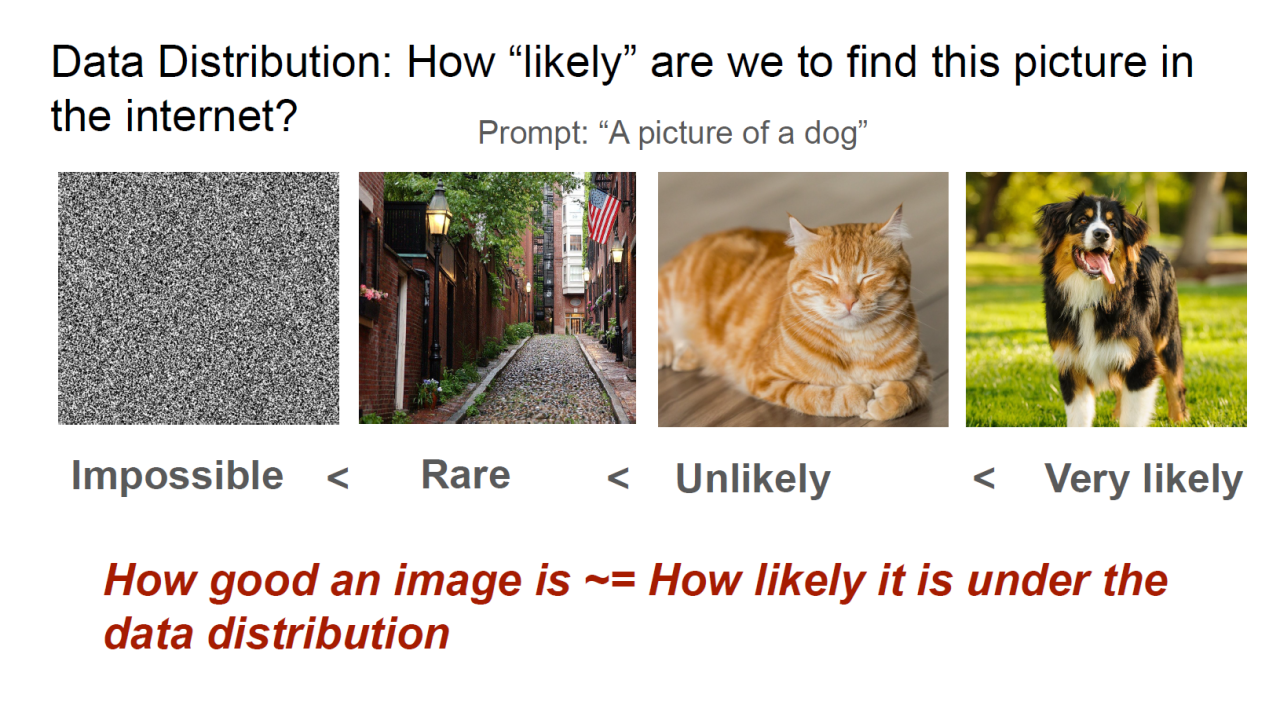
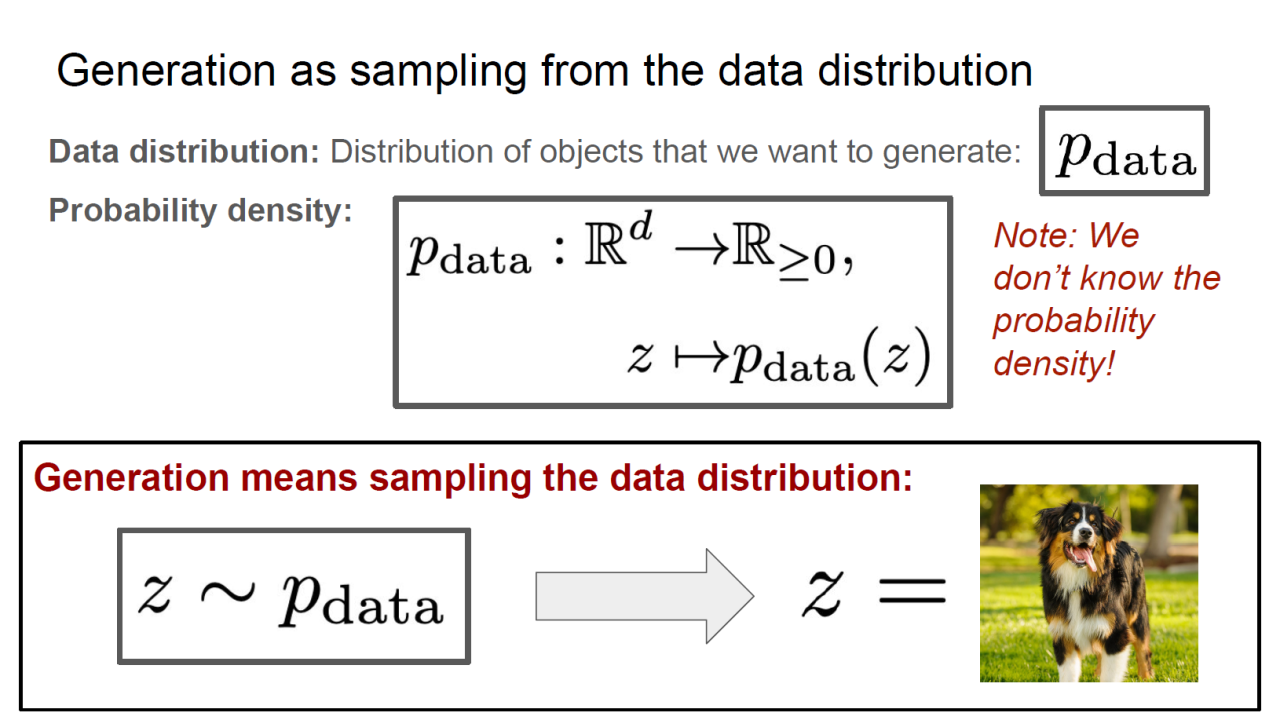
在这样的视角下,数据的生成过程实际上就是从概率密度函数中采样的过程。类似地,我们的训练数据也可以看作是从真实数据分布中获得的一次抽样。
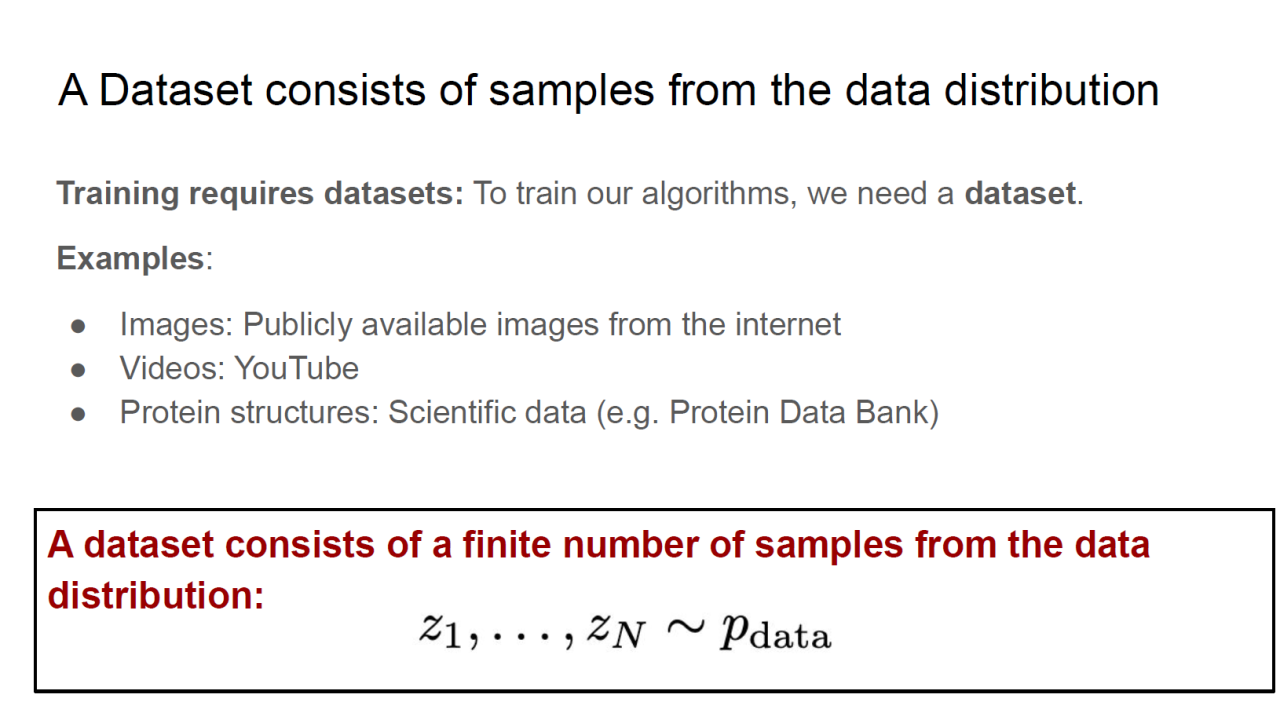
值得额外说明的是,实践中应用更为广泛的是条件生成模型,它的好处在于可以通过提示词来更好地控制生成结果。从数学的角度看,推广到条件生成模型只需要把普通的概率替换成条件概率即可。后面的课程里我们还会专门介绍相关技术,现阶段先专注于通常的无条件概率。
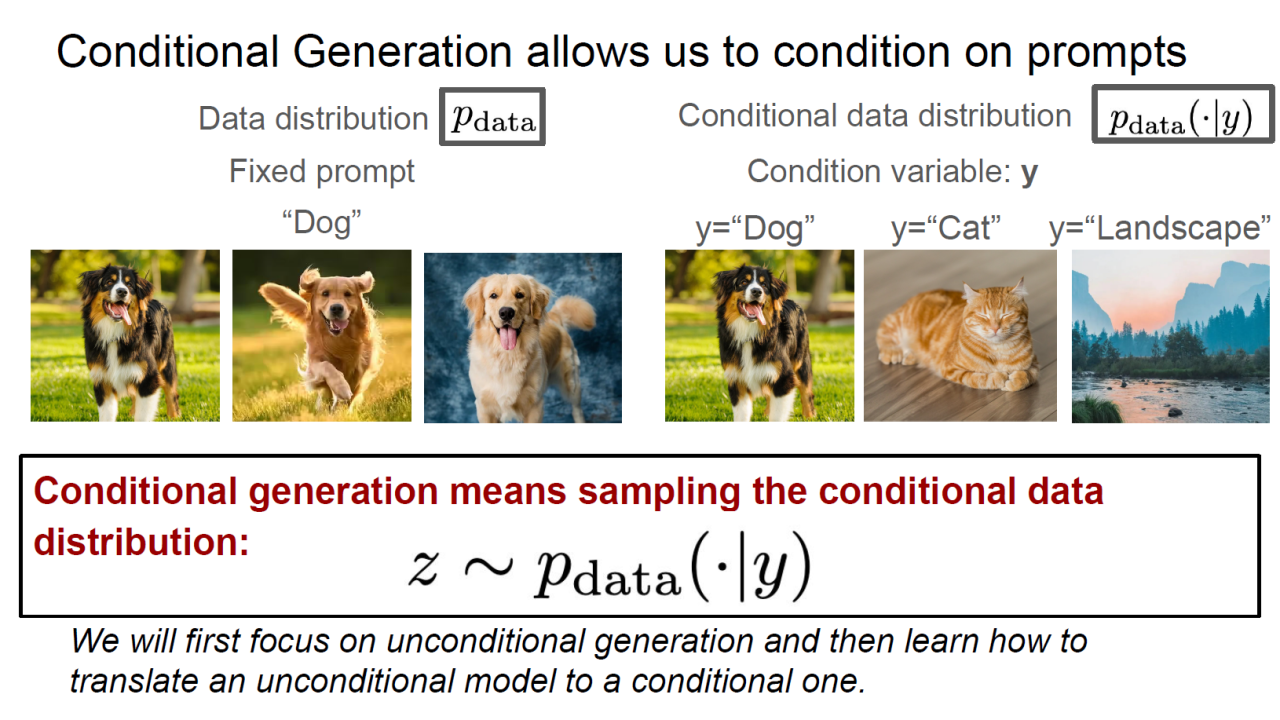
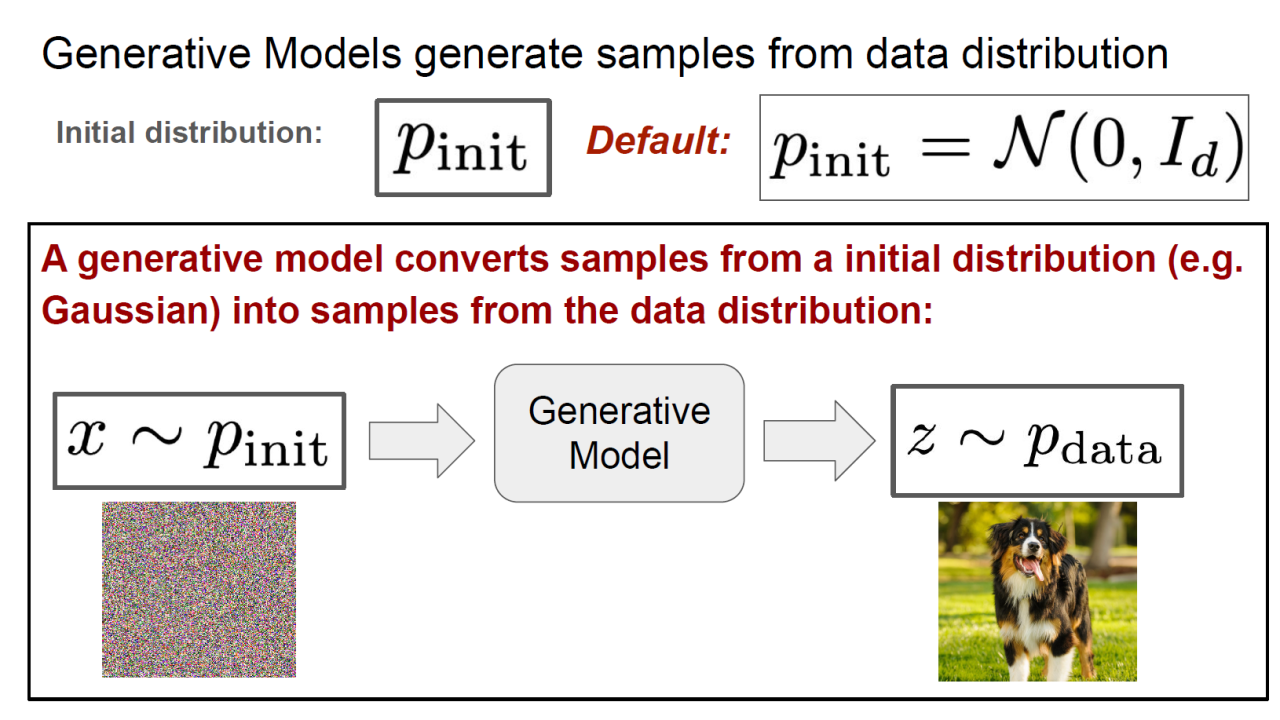
而数据生成则需要从高维数据的概率分布中进行采样。一般来说,直接对高维分布采样是比较困难的,目前通用的做法是从一个相对容易采样的初始分布(如正态分布)出发,再通过模型变换到目标分布上。从这个角度看,生成模型的实质就是从初始分布到目标分布的变换。
Flow and Diffusion Models
Flow Models
接下来我们开始介绍流模型与扩散模型。在进入具体的代码实现之前,我们先回顾一些基本的数学知识。首先我们定义轨迹(Trajectory)为\([0, 1]\)区间到\(\mathbb{R}^{d}\)空间的映射
\[X : [0, 1] \rightarrow \mathbb{R}^{d}, \ \ \ t \mapsto X_t\]向量场(Vector Field)则是一个从\(\mathbb{R}^{d}\)空间到\(\mathbb{R}^{d}\)空间的映射
\[u : \mathbb{R}^{d} \times [0, 1]\rightarrow \mathbb{R}^{d}, \ \ \ (x, t) \mapsto u_t(x)\]二者通过常微分方程(ordinary differential equation, ODE)联系在一起
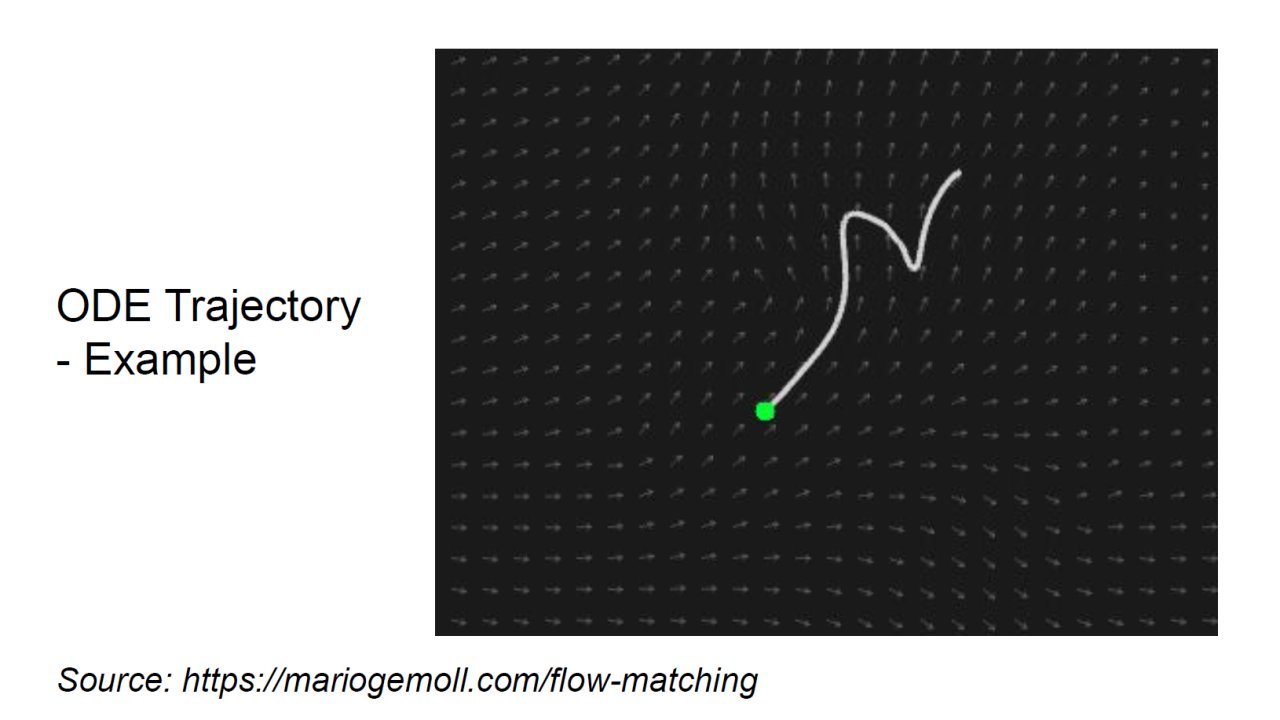
\[\frac{\mathrm{d}}{\mathrm{d} t} X_t = u_t(X_t), \ \ \ X_0 = x_0\]换句话说,向量场和ODE定义了粒子的行为,而粒子的轨迹就是ODE的解。以下图为例,背景中的箭头描述了不同时刻空间中的向量场,白色曲线则是粒子在向量场驱动下的运动轨迹。
基于ODE的概念,我们定义flow\(\psi\)为从初始点\(x_0\)和时间\(t\)到时刻\(t\)所在位置的映射,它随时间的演化由向量场给出,称为flow ODE。其严格的数学定义如下:
\[\begin{aligned} \psi : \mathbb{R}^d \times [0, 1] \rightarrow \mathbb{R}^d, &\quad (x_0, t) \mapsto \psi_t(x_0) \\ \frac{\mathrm{d}}{\mathrm{d} t} \psi_t(x_0) &= u_t(\psi_t(x_0)) \\ \psi_0(x_0) &= x_0 \end{aligned}\]因此从直觉上讲,向量场、ODE和flow描述的其实是同一件事情,即粒子在向量场驱动下的运动轨迹:向量场定义了ODE,而ODE的解就是flow。
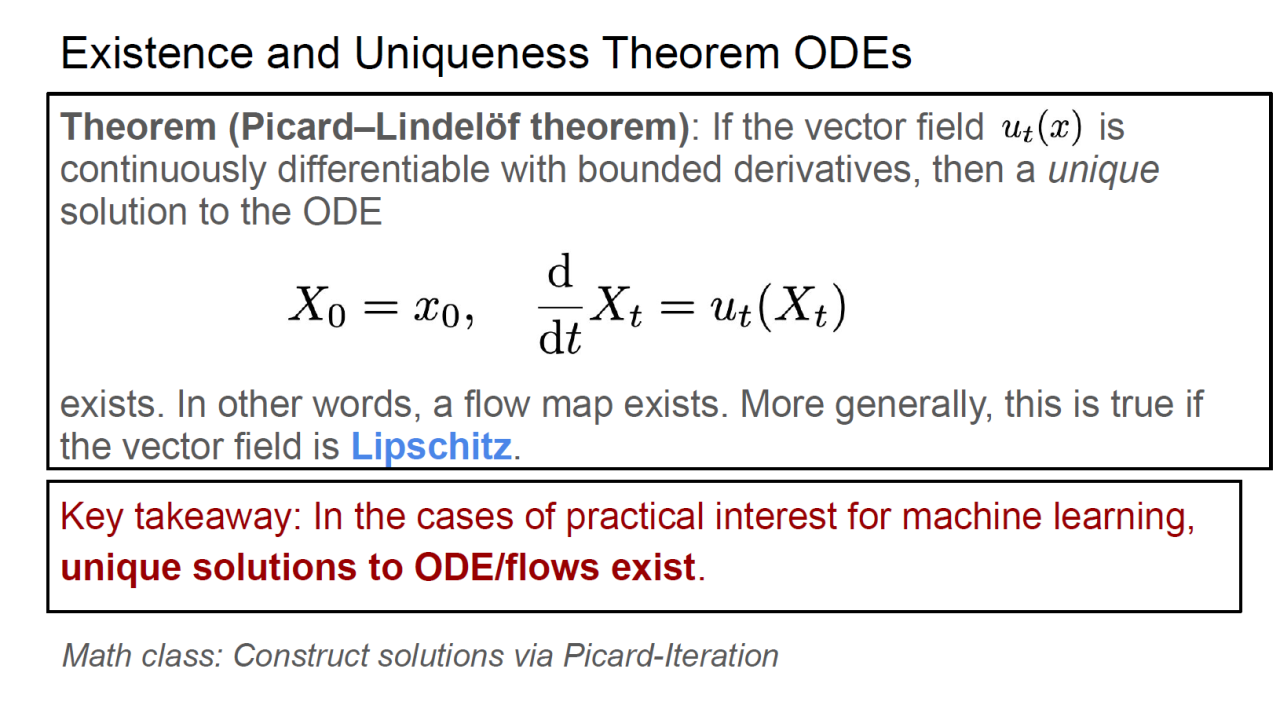
接下来的问题是,ODE是否有解,以及如果有解,解是否唯一。数学上这个问题已经有了答案:当向量场Lipschitz连续时,ODE存在唯一解,这就是Picard–Lindelöf定理。不过在机器学习的范畴里,我们一般可以直接假定上述条件成立,即ODE以及对应的flow一定存在且唯一。
形式简单的ODE可以通过直接求解获得解析解。以下图为例,对于向量场\(u_t(x) = -\theta x\),其解析解为
\[\psi_t(x_0) = \exp(-\theta t) x_0\]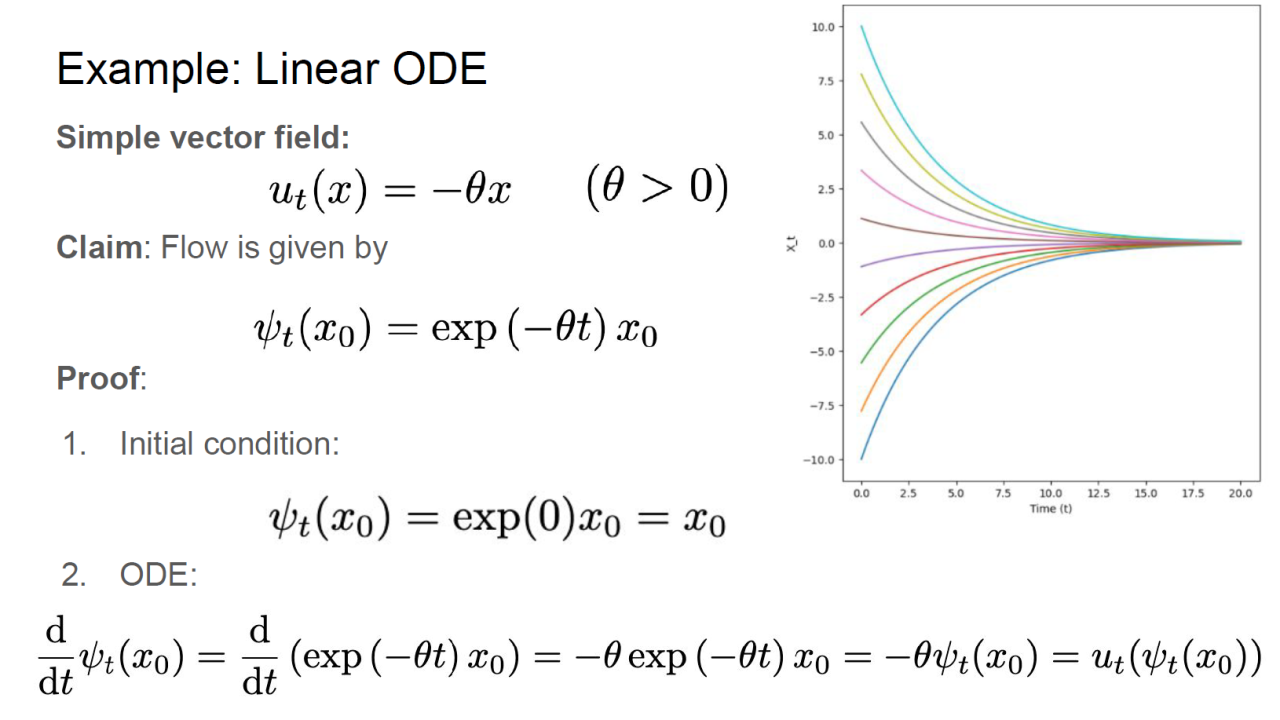
不过大多数情况下ODE是无法解析求解的,此时需要通过数值方法来近似求解。目前最简单也最常用的方法是Euler方法,它通过前向积分来近似求解ODE。
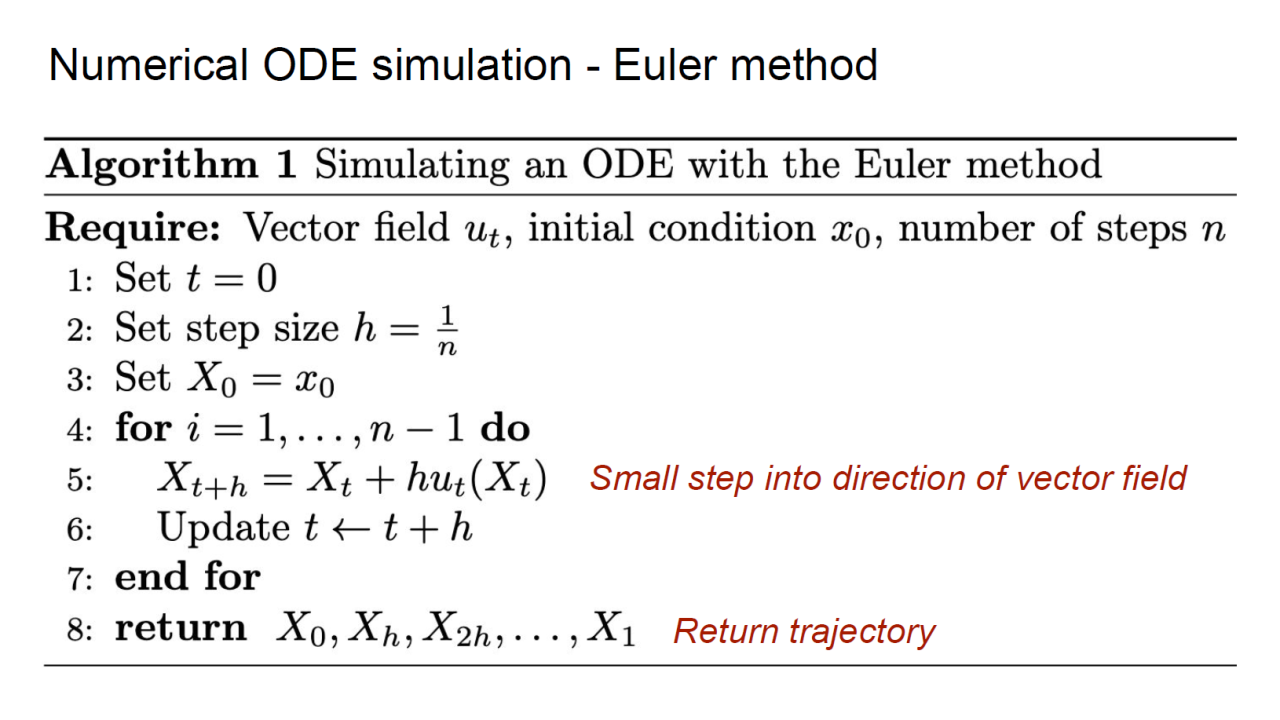
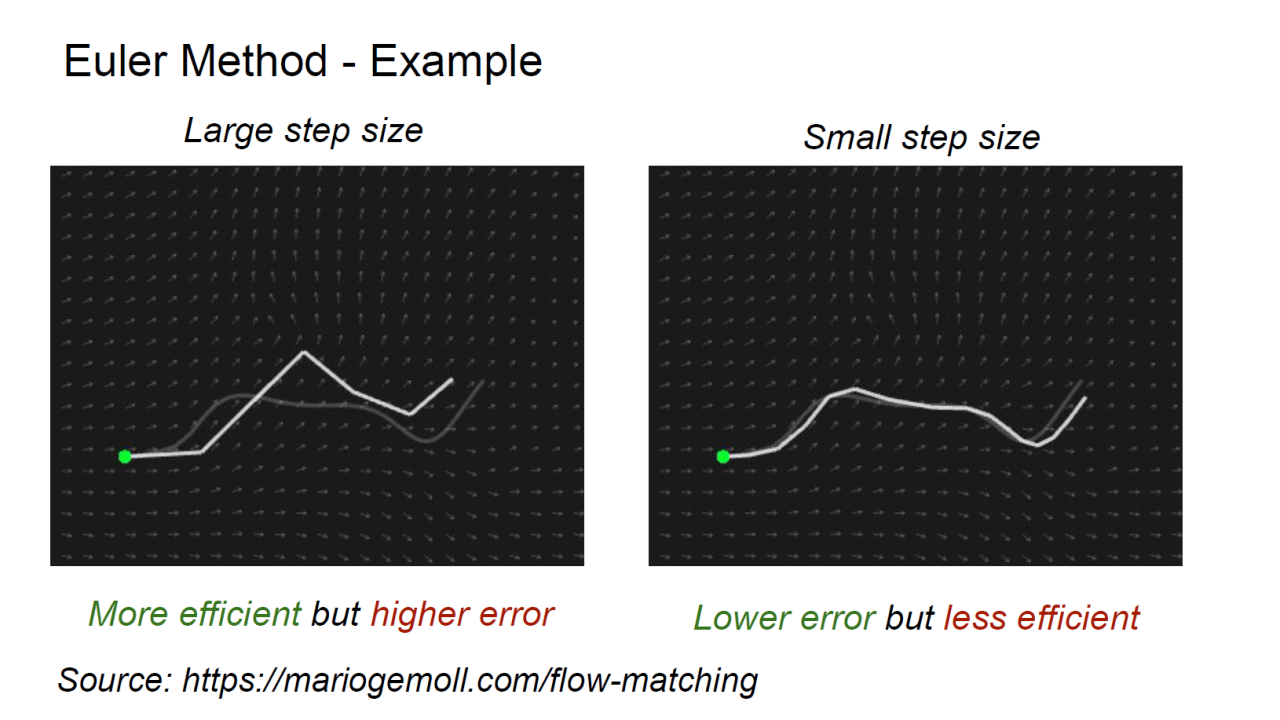
对于Euler方法,积分步长\(h\)对最终结果有很大的影响。步长过大会降低精度,而步长过小则会影响效率,实际应用中需要对二者进行权衡。
回到机器学习和生成模型的话题。前面已经介绍过,生成过程可以理解为从初始分布到目标分布的变换,因此我们可以利用flow将初始分布\(p_\text{init}\)变换到目标分布\(p_\text{data}\)上。具体来说,给定一个训练好的神经网络向量场\(u_t^\theta\),我们可以通过Euler方法从初始分布中采样,再逐步积分到目标分布,这样就得到了如下所示的流模型数据生成算法。
\begin{algorithm}
\caption{Sampling from a Flow Model with Euler method}
\begin{algorithmic}
\REQUIRE Neural network vector field $u_t^\theta$, number of steps $n$
\STATE Set $t = 0$
\STATE Set step size $h = \frac{1}{n}$
\STATE Draw a sample $X_0 \sim p_\text{init}$
\FOR{$i = 1, \ldots, n$}
    \STATE $X_{t+h} = X_t + h u_t^\theta(X_t)$
    \STATE Update $t \leftarrow t + h$
\ENDFOR
\RETURN $X_1$
\end{algorithmic}
\end{algorithm}
Diffusion Models
扩散模型和流模型整体上是类似的,区别在于扩散模型需要在轨迹中引入随机性。为此我们需要借助随机微分方程(stochastic differential equation, SDE)来进行描述。回顾一下,在ODE中轨迹的微分可以表示为
\[\mathrm{d} X_t = u_t(X_t) \ \mathrm{d} t\]而在SDE中,我们还需要加入随机微分项来表示随机性
\[\mathrm{d} X_t = u_t(X_t) \ \mathrm{d} t + \sigma_t \ \mathrm{d} W_t\]其中\(\sigma_t\)称为扩散系数(diffusion coefficient),\(W_t\)则是布朗运动(Brownian motion)。
布朗运动也称为Wiener过程(Wiener process),它是一类非常重要的随机过程。其初值为\(W_0 = 0\),且满足以下两条重要性质:
- 正态增量(Normal increments): 对于任意两个时刻\(0 \leq s \lt t\),布朗运动的增量服从正态分布,且方差与时间差成正比,即\(W_t - W_s \sim \mathcal{N} (0, (t-s) I_d)\)
- 独立增量(Independent increments): 任意两个不重叠时间段上的增量相互独立
利用正态增量的性质,我们可以按如下方式构造布朗运动
\[W_{t+h} = W_t + \sqrt{h} \epsilon, \quad \epsilon \sim \mathcal{N}(0, I_d)\]需要额外说明的是,这里我们对微分符号\(\mathrm{d}\)的使用并不严格:由于随机性的存在,实际上无法直接进行微分运算,这里的微分符号应当理解为差分。以ODE为例,其前向过程可以表示为
\[\begin{aligned} \frac{\mathrm{d}}{\mathrm{d} t} X_t = u_t(X_t) &\Leftrightarrow \frac{1}{h} (X_{t+h} - X_t) = u_t(X_t) \\ &\Leftrightarrow X_{t+h} = X_t + h u_t(X_t) + h R_t(h) \end{aligned}\]其中\(R_t(h)\)是积分误差,满足
\[\lim_{h \to 0} R_t(h) = 0\]对于SDE的情况则可以表示为
\[X_{t+h} = X_t + \underbrace{h u_t(X_t)}_{\text{deterministic}} + \underbrace{\sigma_t (W_{t+h} - W_t)}_{\text{stochastic}} + \underbrace{h R_t(h)}_{\text{error term}}\]其中随机误差项\(R_t(h)\)的标准差满足
\[\lim_{h \to 0} \mathbb{E}[R_t(h)^2]^{1/2} = 0\]类似于ODE的情况,SDE的解是否存在以及是否唯一同样由向量场\(u_t(x)\)决定。不过在实际应用中,我们一般直接假定SDE的解存在且唯一。
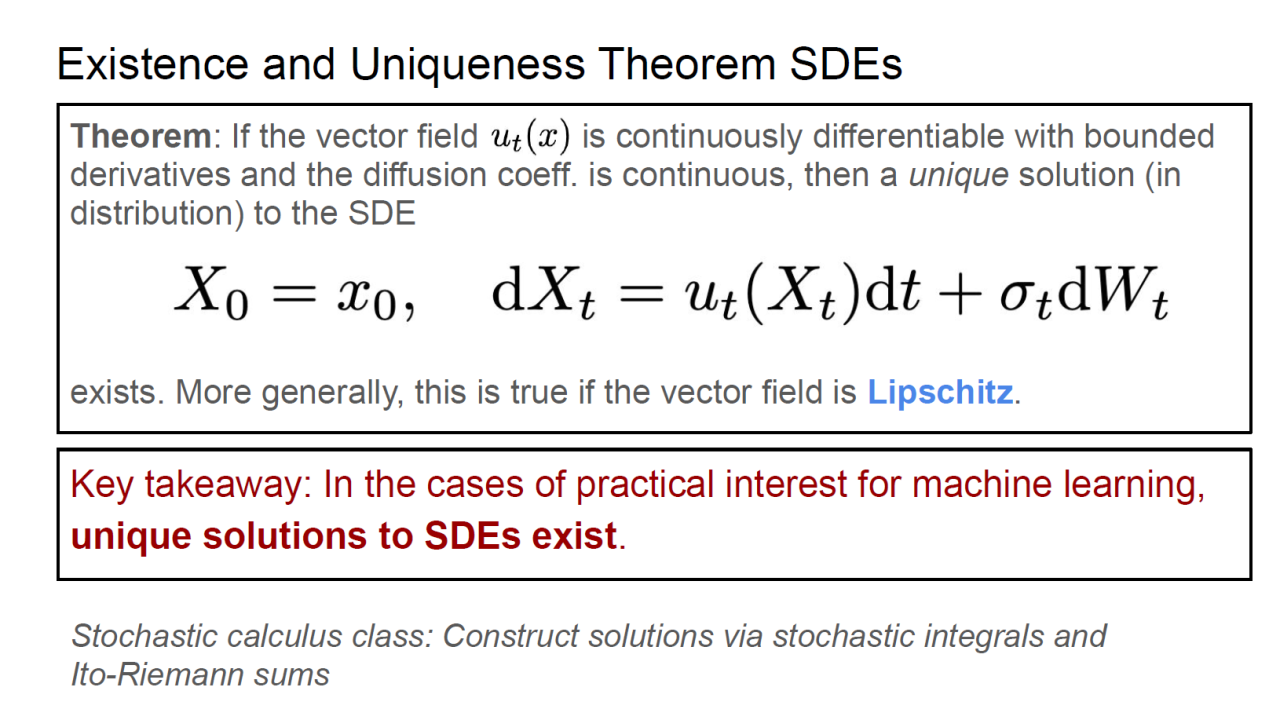
同样,我们也可以通过Euler方法来近似求解SDE,这种方法称为Euler-Maruyama方法。基于Euler-Maruyama方法的扩散模型生成算法流程如下:
\begin{algorithm}
\caption{Sampling from a Diffusion Model (Euler-Maruyama method)}
\begin{algorithmic}
\REQUIRE Neural network $u_t^\theta$, number of steps $n$, diffusion coefficient $\sigma_t$
\STATE Set $t = 0$
\STATE Set step size $h = \frac{1}{n}$
\STATE Draw a sample $X_0 \sim p_\text{init}$
\FOR{$i = 1, \ldots, n$}
    \STATE Draw a sample $\epsilon \sim \mathcal{N}(0, I_d)$
    \STATE $X_{t+h} = X_t + h u_t^\theta(X_t) + \sigma_t \sqrt{h} \epsilon$
    \STATE Update $t \leftarrow t + h$
\ENDFOR
\RETURN $X_1$
\end{algorithmic}
\end{algorithm}